GLM-5.3 の料金:入力・出力・キャッシュの費用
GLM-5.3 のトークン単価、キャッシュ入力、推論設定を解説。リクエスト料金を見積もり、API 使用料と Coding Plan の違いを確認できます。
Markdown で読むGLM-5.3 の料金は、通常入力、キャッシュ入力、出力の 3 つの数量で決まります。 Z.ai の公開定価は、100万トークンあたり順に $1.40、$0.26、$4.40 です。 2026 年 10 月 29 日に確認したメーカーの価格です。SeedRouter の現在の料金は、下の最新料金表を使ってください。[1]
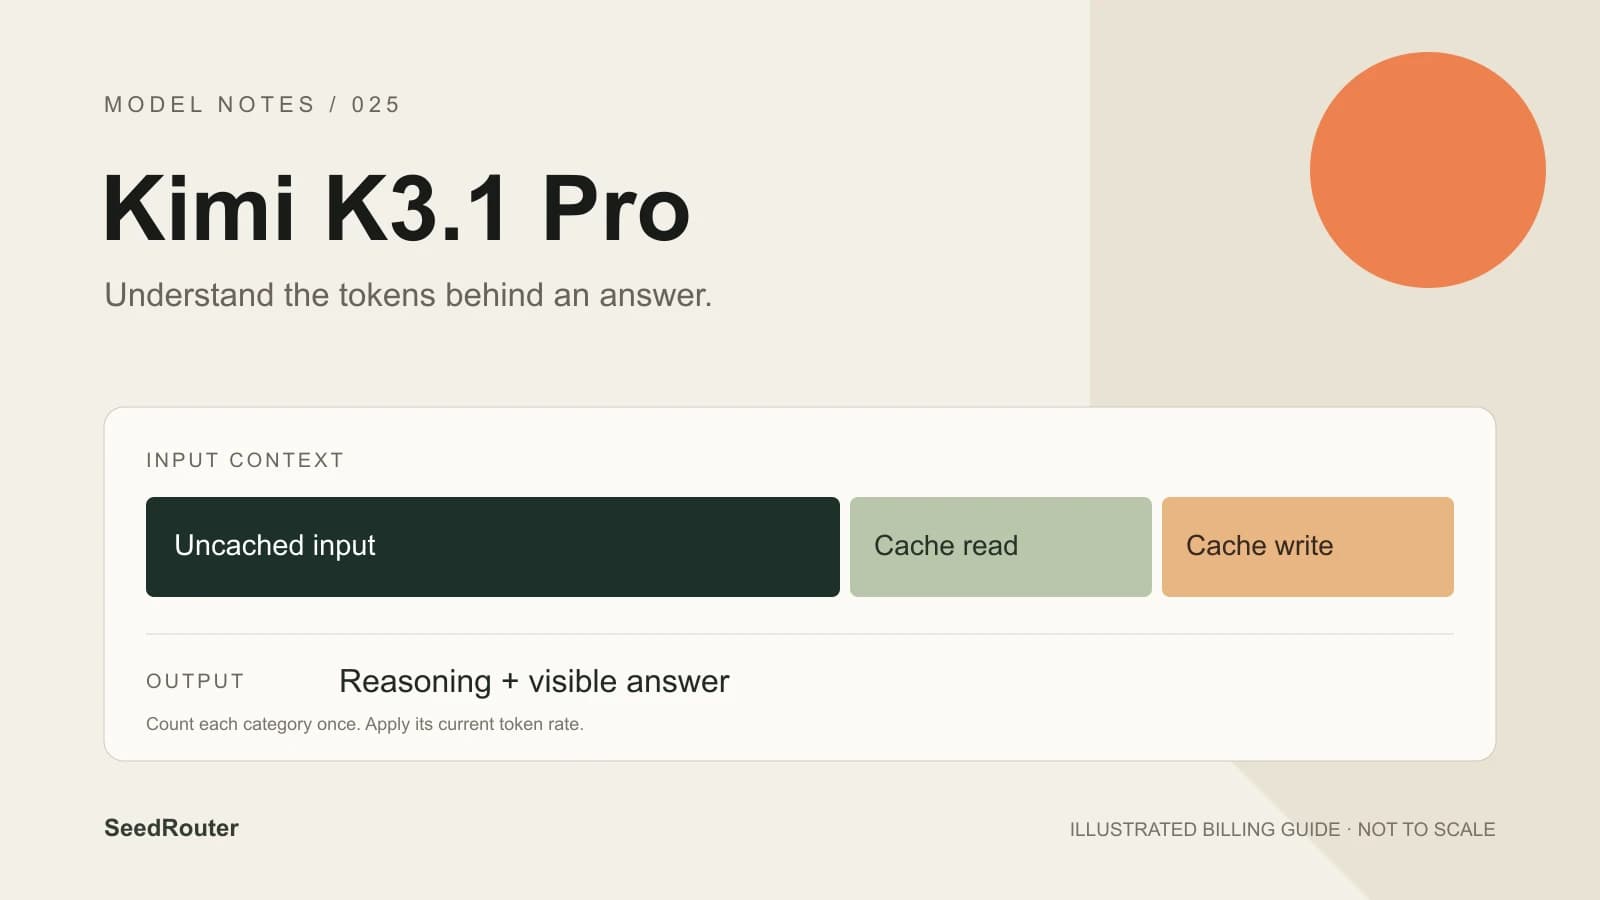
リクエストの見積もりでは 2 点が重要です。キャッシュトークンはプロンプトの一部なので、総入力に加算すると同じテキストを二重に計上します。推論トークンは出力の一部なので、表示される回答の長さだけでは、課金対象となった処理量を過小評価する場合があります。
GLM-5.3 のモデルページには Playground、モデルの制限、最新料金をまとめています。このガイドでは、キャッシュヒットを前提にしたり、計算例を実測結果として示したりせず、リクエストの料金計算を説明します。
SeedRouter の現在の GLM-5.3 料金
次の表は課金設定から現在の単価を取得します。このサービス経由のリクエストには、この料金を使ってください。
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
見積もりにはモデル ID も記録してください。Default のモデル ID は glm-5.3 です。GLM-5.3、GLM-5.3-Flash、GLM-5.3-FlashX は別のモデルです。似た名前のモデルの価格では、自分のリクエスト料金は判断できません。
100万トークンのコンテキストは容量の上限で、固定の購入単位ではありません。少量のテキストを含むリクエストで、コンテキストウィンドウ全体を購入するわけではありません。そのリクエストで実際に返された入力と出力の数量を使ってください。[2]
料金計算にはどのトークンを含めますか?
Chat Completions のレスポンスでは、usage 内の次の項目を読み取ります。
| 項目 | 意味 |
|---|---|
prompt_tokens | キャッシュ入力を含む総入力 |
prompt_tokens_details.cached_tokens | キャッシュから提供された入力部分 |
completion_tokens | 推論を含む出力 |
total_tokens | 入力と出力の合計。第 3 の課金区分ではありません |
100万トークンあたりの単価を使う場合、通常は次のように計算します。
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
総入力 10,000 トークン、キャッシュ入力 2,000 トークン、出力 1,000 トークンという仮のリクエストを考えます。通常入力は 8,000 トークンです。上記の日付時点の Z.ai 定価では、(8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000、つまり $0.01612 になります。これはメーカーの単価を使った計算例であり、実測リクエストでも、このサービスの料金見積書でもありません。
レスポンスでキャッシュ書き込みが別に報告される場合は、該当する最新単価を適用し、その報告分も通常入力から差し引きます。テキストの長さから書き込み数量を作り出さないでください。API リファレンスでは、3 つのプロトコル形式での使用量の表し方を説明しています。項目名は相互に置き換えられません。
キャッシュ入力とは何ですか?
GLM-5.3 に文書化されているコンテキストキャッシュは自動です。通常の Chat リクエストで、明示的なキャッシュ有効期間を指定する必要はありません。指示に続く参照資料など、変更のない接頭部分を再利用すると、キャッシュを利用できる可能性があります。その部分を変更すると、ヒットの可能性も変わります。[3]
利用条件を満たすことは、ヒットした証拠ではありません。似たテキストの量から節約額を推測せず、完了したレスポンスの prompt_tokens_details.cached_tokens を確認してください。公式のキャッシュ例では、総プロンプト 1,200 トークンのうち 800 トークンがキャッシュ入力で、残る 400 トークンだけが通常入力です。
メーカーの料金ページでは、キャッシュの保存は一時的に無料と別途説明されています。ただし、キャッシュされたすべてのリクエストの推論が無料になるわけではなく、固定の有効期間や、同じテキストで必ずヒットすることを保証するものでもありません。別モデルの 5 分・1 時間の書き込み料金体系を、GLM-5.3 に適用する根拠にもなりません。[1]
自分のレスポンスでキャッシュ使用量を確認できるまでは、控えめに見積もってください。新しい処理の予算には、キャッシュなしの計算が出発点になります。代表的な結果が集まったら、タスク全体で実際の非キャッシュ入力、キャッシュ入力、出力を比較します。
短い回答でも出力トークンが多くなる理由
GLM-5.3 は常に推論します。推論強度は low、high、max で、文書上のデフォルトは max です。low は推論の無効化を意味しません。thinking.type: "disabled" は受け付けません。[2]
推論と回答テキストは出力上限を共有します。1 文の回答にも多くの推論が先行する場合があり、上限が小さすぎると有用な回答が出る前に停止することもあります。リクエストが合格基準を満たしたと判断する前に、終了理由または終端ステータスを確認してください。
これらの推論強度に対する料金倍率は文書化されていません。強度はモデルの取り組み方に影響し、請求額はトークン数量で決まります。アプリケーションでの利点と費用を把握するには、同じ入力と検証基準で強度を比較してください。自分で追加すると決めたリクエストも含め、タスクを完了するための総費用を記録します。
最大出力は 131,072 トークンです。Chat のリクエストスキーマではデフォルトの出力上限は公表されていません。Responses には 65,536 と記載されています。どちらも、小さなタスクで最大値を指定すべきという意味ではありません。推論と必要な回答のための余裕を確保し、実際の使用量を確認してください。
API 課金と Coding Plan の違い
Z.ai の Coding Plan は別のサブスクリプション商品です。コーディングツールが API リクエストを行うことだけでは、どの残高や契約から支払われるかは決まりません。
メーカーの API キー規則は 2026 年 10 月 16 日に変更されました。新規発行の Standard API キーと Coding Plan キーは課金種別が分かれています。エンドポイントを変えても、新しいキーの課金種別は変わりません。従来の Compatible キーにはエンドポイントに応じた別の規則があるため、既存の構成を確認する際は最新のキー管理ガイドを参照してください。[4]
SeedRouter のキーによるリクエストは、このサービスのプリペイド残高と最新単価を使います。外部の Coding Plan の利用枠は引き継がれません。クライアントの変更で費用の前提が知らないうちに変わらないよう、連携メモにはキー発行元、モデル ID、料金の参照元をまとめて記録してください。
最初のリクエスト前によくある質問
GLM-5.3 は無料ですか?
このサービスのリクエストは、上記の最新単価でプリペイド残高を使用します。サブスクリプション契約は不要で、失敗したリクエストは課金されません。トークン単価が低くても従量料金は発生します。バッチ実行前に入力と出力の両方を見積もってください。
GLM-5.3-Flash の料金は適用されますか?
いいえ。このガイドの対象は、テキスト専用のフラッグシップ GLM-5.3 です。Flash と FlashX はモデルの識別子、機能、料金がそれぞれ異なります。リクエストの正確なモデル ID と、使う料金表を照合してください。
長いコンテキストは必ず高くなりますか?
容量そのものには課金されません。実際の入力トークンが増えると通常は入力使用量も増えますが、キャッシュヒットによって入力の一部に適用される単価が変わります。長い出力も総額に影響するため、入力と出力の両方を比較してください。
バッチ処理の料金はどう見積もりますか?
短いプロンプト 1 件だけでなく、代表的なタスクから始めてください。各リクエストの入力、キャッシュ、出力の使用量を記録します。それぞれに該当する単価を掛け、バッチ全体で合算します。各結果が合格基準を満たしたかも別に記録してください。安価でも未完了の回答は、完了した仕事にはなりません。
パラメーターはどこで確認できますか?
Chat、Responses、Messages の完全な項目表は GLM-5.3 API リファレンスを参照してください。Playgroundでは送信前にリクエストを確認できます。検証できる質問から始め、回答と一緒に使用量も読み取ってください。
出典
- Z.ai の料金、2026 年 10 月 29 日確認。
- GLM-5.3 モデルガイド、2026 年 10 月 29 日確認。
- コンテキストキャッシュ、2026 年 10 月 29 日確認。
- API キー管理、2026 年 10 月 29 日確認。