Tarifs GLM-5.3 : coûts d’entrée, de sortie et du cache
Comparez les tarifs GLM-5.3, l’entrée en cache et le raisonnement. Estimez une requête et distinguez l’usage API d’un abonnement de programmation.
Lire en MarkdownLes tarifs de GLM-5.3 reposent sur trois quantités principales : entrée ordinaire, entrée en cache et sortie. Les prix catalogue publiés par Z.ai sont respectivement de 1,40 $, 0,26 $ et 4,40 $ par million de tokens, vérifiés le 29 octobre 2026. Ce sont les prix du fabricant. Utilisez le tableau actuel ci-dessous pour les tarifs en vigueur sur SeedRouter.[1]
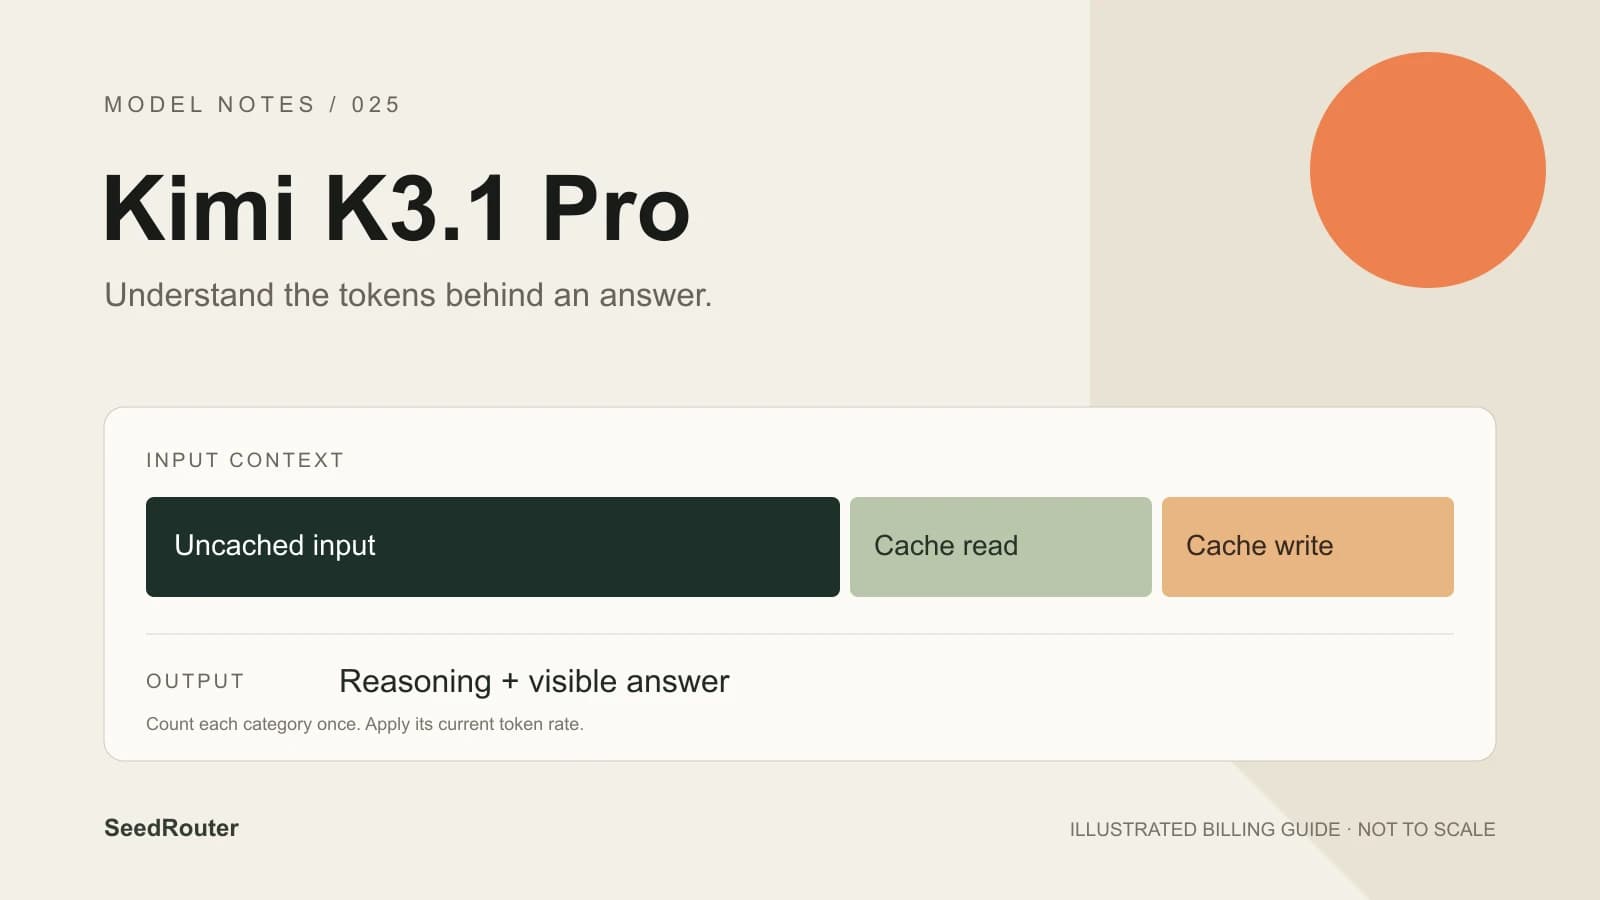
Deux détails comptent pour estimer une requête. Les tokens en cache font partie du prompt : les ajouter à l’entrée totale revient à facturer deux fois le même texte. Les tokens de raisonnement font partie de la sortie : la longueur de la réponse visible peut sous-estimer le travail facturé.
La page du modèle GLM-5.3 réunit le Playground, les limites du modèle et les tarifs actuels. Ce guide explique le calcul d’une requête sans supposer un accès au cache ni présenter un exemple de calcul comme un résultat mesuré.
Tarifs actuels de GLM-5.3 sur SeedRouter
Le tableau suivant lit les tarifs actuels dans les paramètres de facturation. Utilisez cette source pour les requêtes effectuées via ce service.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
Conservez l’ID du modèle avec votre estimation : l’ID du niveau Default est glm-5.3. GLM-5.3, GLM-5.3-Flash et GLM-5.3-FlashX sont des modèles distincts. Le prix d’un modèle au nom similaire ne détermine pas le coût de votre requête.
Le contexte d’un million de tokens est une limite de capacité, pas un achat forfaitaire. Une requête contenant peu de texte n’achète pas toute la fenêtre de contexte. Utilisez les quantités d’entrée et de sortie réellement renvoyées pour cette requête.[2]
Quels tokens entrent dans le calcul ?
Pour une réponse Chat Completions, lisez ces champs dans usage :
| Champ | Signification |
|---|---|
prompt_tokens | Entrée totale, entrée en cache comprise |
prompt_tokens_details.cached_tokens | Portion de l’entrée servie depuis le cache |
completion_tokens | Sortie, raisonnement compris |
total_tokens | Entrée plus sortie ; pas une troisième catégorie de facturation |
Avec des tarifs par million de tokens, le calcul ordinaire est :
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
Prenons une requête hypothétique de 10 000 tokens d’entrée totale, dont 2 000 en cache, et de 1 000 tokens de sortie. L’entrée ordinaire est de 8 000 tokens. Avec les prix catalogue Z.ai datés ci-dessus, le calcul est (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, soit 0,01612 $. C’est un exemple arithmétique aux tarifs du fabricant, pas une requête mesurée ni un devis de ce service.
Si une réponse signale séparément des écritures en cache, appliquez le tarif actuel correspondant et soustrayez aussi cette portion de l’entrée ordinaire. N’inventez pas un nombre de tokens écrits à partir de la longueur du texte. La référence API explique comment les trois protocoles expriment l’usage ; leurs noms de champs ne sont pas interchangeables.
Que signifie l’entrée en cache ?
Le cache de contexte documenté de GLM-5.3 est automatique. Une requête Chat ordinaire n’exige pas de durée de cache explicite. Réutiliser un préfixe inchangé, par exemple des consignes suivies de documents de référence, rend une réutilisation possible ; modifier ce préfixe peut changer les possibilités d’accès au cache.[3]
L’éligibilité ne prouve pas un accès au cache. Lisez prompt_tokens_details.cached_tokens dans la réponse terminée au lieu d’estimer les économies selon la quantité de texte familier. L’exemple officiel inclut 800 tokens en cache dans un total de 1 200 tokens de prompt ; seuls les 400 restants sont de l’entrée ordinaire.
La page des tarifs du fabricant décrit séparément le stockage du cache comme temporairement gratuit. Cela ne rend pas gratuite toute inférence avec cache, ne fixe aucune durée de vie et ne garantit pas qu’un texte répété sera servi depuis le cache. Cela ne justifie pas non plus d’appliquer à GLM-5.3 les paliers d’écriture de cinq minutes et d’une heure d’un autre modèle.[1]
Gardez des estimations prudentes jusqu’à disposer de vos propres mesures de cache. Pour budgéter de nouvelles tâches, un calcul sans cache constitue un point de départ utile. Une fois les résultats représentatifs disponibles, comparez l’entrée réelle sans cache, l’entrée en cache et la sortie sur des tâches complètes.
Pourquoi une réponse courte peut consommer beaucoup de tokens de sortie
GLM-5.3 raisonne toujours. Les efforts proposés sont low, high et max, avec max comme défaut documenté. Un effort faible ne désactive pas le raisonnement. Le modèle n’accepte pas thinking.type: "disabled".[2]
Raisonnement et texte de réponse partagent le budget de sortie. Une seule phrase peut suivre un raisonnement important, tandis qu’une limite trop faible peut arrêter la génération avant toute réponse utile. Vérifiez la raison de fin ou l’état final avant de décider si la requête satisfait vos critères d’acceptation.
Aucun multiplicateur de prix n’est documenté pour ces niveaux d’effort. Ils influencent la façon d’aborder une tâche ; les quantités de tokens déterminent la facture. Comparez les réglages sur les mêmes entrées et vérifications pour comprendre le compromis dans votre application. Consignez le coût total d’une tâche terminée, y compris les requêtes supplémentaires que vous choisissez d’effectuer.
Le plafond de sortie est de 131 072 tokens. Le schéma de requête Chat ne publie pas de plafond par défaut ; Responses documente un défaut de 65 536. Aucun des deux ne recommande de demander le maximum pour une petite tâche. Choisissez assez de marge pour le raisonnement et la réponse voulue, puis examinez l’usage réel.
Facturation API et Coding Plan
Le Coding Plan de Z.ai est un abonnement distinct. Un outil de programmation peut envoyer des requêtes API, mais cela ne suffit pas à déterminer le solde ou l’abonnement qui les paie.
Les règles de clés API du fabricant ont changé le 16 octobre 2026. Les nouvelles clés Standard API et Coding Plan ont des types de facturation distincts. Changer d’endpoint ne change pas le type de facturation d’une nouvelle clé. Les anciennes clés Compatible suivent d’autres règles selon l’endpoint : consultez le guide actuel de gestion des clés pour vérifier une configuration existante.[4]
Les requêtes avec une clé SeedRouter utilisent le crédit prépayé et les tarifs actuels de ce service. Un abonnement Coding Plan externe ne transfère pas son quota ici. Notez ensemble l’émetteur de la clé, l’ID du modèle et la source des tarifs pour qu’un changement de client ne modifie pas discrètement vos hypothèses de coût.
Questions avant votre première requête
GLM-5.3 est-il gratuit ?
Les requêtes ici utilisent le crédit prépayé aux tarifs actuels ci-dessus. Aucun abonnement n’est requis et les requêtes échouées ne sont pas facturées. Même faible, un tarif par token reste un coût d’usage ; estimez entrée et sortie avant de lancer un lot.
Les tarifs GLM-5.3-Flash s’appliquent-ils ?
Non. Ce guide concerne le modèle phare textuel GLM-5.3. Flash et FlashX ont leurs propres identités, capacités et tarifs. Faites correspondre l’ID exact de votre requête au tableau tarifaire utilisé.
Un long contexte coûte-t-il toujours plus cher ?
La capacité elle-même n’est pas facturée. Davantage de tokens d’entrée réels augmente généralement l’usage en entrée, tandis que le cache peut modifier le tarif d’une portion de cette entrée. Une sortie longue change aussi le total : comparez les deux côtés de la requête.
Comment estimer un lot ?
Commencez par des tâches représentatives plutôt que par un seul prompt court. Relevez l’usage en entrée, en cache et en sortie de chaque requête. Multipliez ces quantités par les tarifs applicables, puis additionnez sur le lot. Notez séparément si chaque résultat satisfait vos vérifications ; des réponses incomplètes bon marché ne constituent pas un travail terminé.
Où examiner les paramètres ?
La référence API GLM-5.3 contient les tableaux complets de champs Chat, Responses et Messages. Le Playground permet d’examiner une requête avant envoi. Commencez par une question vérifiable et lisez l’usage avec la réponse.
Sources
- Tarifs Z.ai, vérifiés le 29 octobre 2026.
- Guide du modèle GLM-5.3, vérifié le 29 octobre 2026.
- Cache de contexte, vérifié le 29 octobre 2026.
- Gestion des clés API, vérifiée le 29 octobre 2026.