Preços do GLM-5.3: custos de entrada, saída e cache
Compare tarifas de tokens do GLM-5.3, entrada em cache e raciocínio. Estime o custo de uma requisição e diferencie uso de API de assinatura.
Ler em MarkdownO preço do GLM-5.3 envolve três quantidades principais: entrada comum, entrada em cache e saída. As tarifas de tabela publicadas pela Z.ai são, respectivamente, US$ 1,40, US$ 0,26 e US$ 4,40 por milhão de tokens, verificadas em 29 de outubro de 2026. Esses são preços do fabricante. Consulte a tabela dinâmica abaixo para conferir as tarifas atuais no SeedRouter.[1]
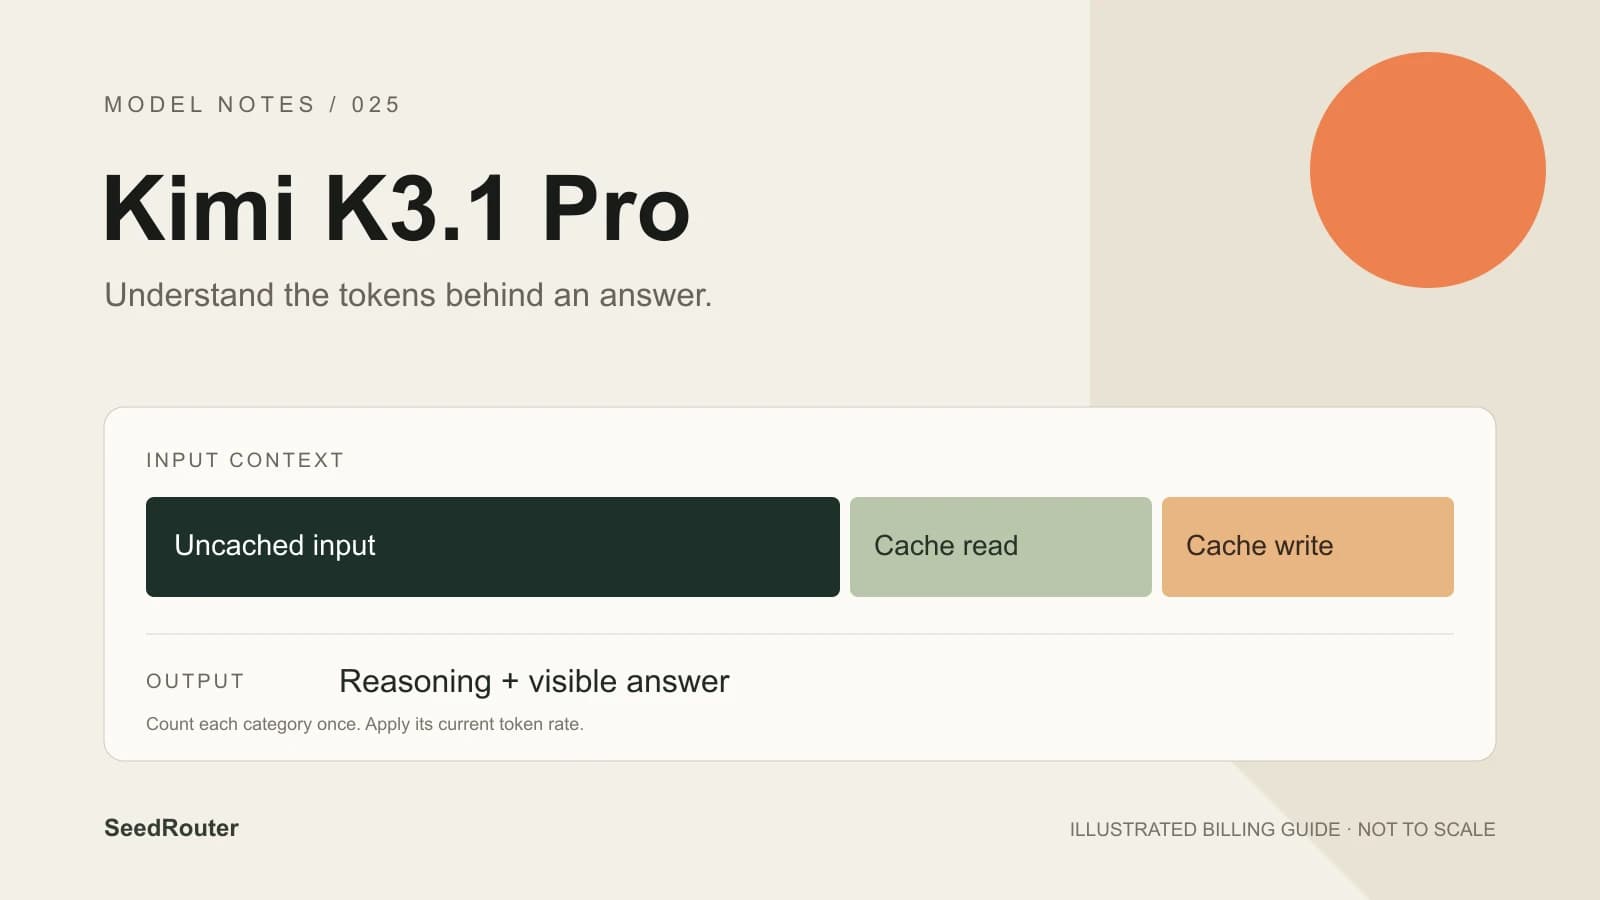
Dois detalhes são importantes ao estimar uma requisição. Tokens em cache fazem parte do prompt; somá-los à contagem total de entrada cobra duas vezes pelo mesmo texto. Tokens de raciocínio fazem parte da saída, de modo que o tamanho da resposta visível pode subestimar o trabalho cobrado.
A página do modelo GLM-5.3 reúne Playground, limites do modelo e preços atuais. Este guia explica o cálculo de uma requisição sem pressupor um acerto de cache nem apresentar um cálculo ilustrativo como resultado medido.
Preços atuais do GLM-5.3 no SeedRouter
A tabela a seguir consulta as tarifas atuais nas configurações de cobrança. Use essa fonte de preços para requisições feitas por este serviço.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
Mantenha o ID do modelo junto da estimativa: o ID do modelo Default é glm-5.3. GLM-5.3, GLM-5.3-Flash e GLM-5.3-FlashX são modelos diferentes. O preço de um nome parecido não determina o custo da sua requisição.
O contexto de um milhão de tokens é um limite de capacidade, não uma compra fixa. Uma requisição com pouco texto não compra a janela de contexto inteira. Use as contagens de entrada e saída efetivamente retornadas para aquela requisição.[2]
Quais tokens entram no cálculo?
Em uma resposta Chat Completions, leia estes campos dentro de usage:
| Campo | Significado |
|---|---|
prompt_tokens | Entrada total, incluindo a entrada em cache |
prompt_tokens_details.cached_tokens | Parcela da entrada servida pelo cache |
completion_tokens | Saída, incluindo raciocínio |
total_tokens | Entrada mais saída; não é uma terceira categoria de cobrança |
Com tarifas por milhão de tokens, o cálculo comum é:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
Considere uma requisição hipotética com 10.000 tokens de entrada total, 2.000 tokens de entrada em cache e 1.000 tokens de saída. A entrada comum corresponde a 8.000 tokens. Às tarifas de tabela da Z.ai verificadas na data acima, o cálculo é (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, ou US$ 0,01612. É um exemplo aritmético com tarifas do fabricante, não uma requisição medida nem uma cotação deste serviço.
Se uma resposta informar escritas no cache separadamente, siga a tarifa atual aplicável e também subtraia essa parcela da entrada comum. Não invente uma contagem de escrita a partir do tamanho do texto. A referência da API explica como os três formatos de protocolo expressam o uso; os nomes dos campos não são intercambiáveis.
O que significa entrada em cache?
O cache de contexto documentado do GLM-5.3 é automático. Não é necessário declarar um prazo de cache explícito em uma requisição Chat comum. Reutilizar um prefixo inalterado, como instruções seguidas de material de referência, possibilita o reaproveitamento; alterar esse prefixo pode mudar a possibilidade de um acerto.[3]
A elegibilidade não comprova um acerto. Leia prompt_tokens_details.cached_tokens na resposta concluída em vez de estimar a economia pela quantidade de texto familiar. O exemplo oficial de cache inclui 800 tokens em cache em um total de 1.200 tokens de prompt; apenas os 400 restantes são entrada comum.
A página de preços do fabricante descreve separadamente o armazenamento de cache como temporariamente gratuito. Isso não torna gratuita a inferência de toda requisição com cache, não estabelece um prazo fixo nem garante que texto repetido terá um acerto de cache. Também não justifica importar para o GLM-5.3 a tabela de escrita de cinco minutos e uma hora de outro modelo.[1]
Mantenha estimativas conservadoras até que suas próprias respostas informem o uso do cache. Para orçar uma nova carga de trabalho, um cálculo sem cache é um ponto de partida útil. Quando houver resultados representativos, compare entrada sem cache, entrada em cache e saída reais em tarefas completas.
Por que uma resposta curta pode usar muitos tokens de saída
GLM-5.3 sempre raciocina. Os níveis disponíveis são low, high e max, com max como padrão documentado. O nível baixo não desativa o raciocínio. O modelo não aceita thinking.type: "disabled".[2]
O raciocínio e o texto da resposta compartilham o orçamento de saída. Uma resposta de uma frase pode vir após um raciocínio extenso, enquanto um limite muito baixo pode interromper a geração antes de surgir uma resposta útil. Confira o motivo de término ou o status final antes de decidir se a requisição atendeu aos critérios de aceitação.
Não há multiplicador de preço documentado associado a esses níveis. Eles influenciam a abordagem da tarefa pelo modelo; as contagens de tokens determinam a cobrança. Compare os níveis com as mesmas entradas e verificações para entender a relação entre custo e resultado no seu aplicativo. Registre o custo total de concluir uma tarefa, incluindo requisições adicionais que decidir fazer.
O limite de saída é de 131.072 tokens. Chat não publica um limite de saída padrão em seu esquema de requisição; Responses documenta um padrão de 65.536. Nenhum desses valores recomenda solicitar o máximo para uma tarefa pequena. Escolha um orçamento com espaço suficiente para o raciocínio e a resposta desejada e confira o uso real.
Cobrança de API e Coding Plan
O Coding Plan da Z.ai é um produto de assinatura separado. Uma ferramenta de programação pode fazer requisições de API, mas isso por si só não determina qual saldo ou assinatura paga por elas.
As regras de chaves de API do fabricante mudaram em 16 de outubro de 2026. Novas chaves Standard API e Coding Plan têm tipos de cobrança separados. Alterar o endpoint não muda o tipo de cobrança de uma chave nova. Chaves Compatible antigas têm regras diferentes conforme o endpoint; consulte o guia atual de gerenciamento de chaves ao verificar uma configuração existente.[4]
Requisições feitas com uma chave SeedRouter usam o crédito pré-pago e as tarifas atuais deste serviço. Uma assinatura externa Coding Plan não transfere sua franquia para cá. Registre juntos o emissor da chave, o ID do modelo e a fonte dos preços para que uma troca de cliente não altere silenciosamente suas premissas de custo.
Perguntas antes da primeira requisição
O GLM-5.3 é gratuito?
As requisições aqui usam crédito pré-pago às tarifas atuais acima. Não é necessário assinar um plano, e requisições que falham não são cobradas. Uma tarifa baixa ainda é uma cobrança por uso; estime entrada e saída antes de executar um lote.
Os preços do GLM-5.3-Flash se aplicam?
Não. Este guia trata do modelo principal GLM-5.3, que aceita somente texto. Flash e FlashX têm identidades, capacidades e preços próprios. Confira se o ID exato da requisição corresponde à tabela de tarifas utilizada.
Um contexto longo sempre custa mais?
A capacidade em si não é cobrada. Mais tokens reais de entrada geralmente aumentam o uso de entrada, enquanto acertos de cache podem mudar a tarifa de parte dessa entrada. Uma saída longa também altera o total; compare os dois lados da requisição.
Como estimar o custo de um lote?
Comece com tarefas representativas, não apenas um prompt curto. Registre o uso de entrada, cache e saída de cada requisição. Multiplique essas quantidades pelas tarifas aplicáveis e some o lote. Registre separadamente se cada resultado passou nas verificações de aceitação; respostas baratas e incompletas não são trabalho concluído.
Onde posso consultar os parâmetros?
Consulte a referência da API GLM-5.3 para ver tabelas completas de campos de Chat, Responses e Messages. O Playground permite examinar uma requisição antes de enviá-la. Comece com uma pergunta verificável e leia o uso junto da resposta.
Fontes
- Preços da Z.ai, verificado em 29 de outubro de 2026.
- Guia do modelo GLM-5.3, verificado em 29 de outubro de 2026.
- Cache de contexto, verificado em 29 de outubro de 2026.
- Gerenciamento de chaves de API, verificado em 29 de outubro de 2026.