GLM-5.3 价格:输入、输出与缓存费用
比较 GLM-5.3 token 费率、缓存输入和推理设置,估算单次请求费用,并区分 API 用量计费与编程订阅。
以 Markdown 阅读GLM-5.3 价格主要涉及三项用量:普通输入、缓存输入和输出。 Z.ai 公布的标价分别为每百万 token $1.40、$0.26 和 $4.40,核对日期为 2026 年 10 月 29 日。这是厂商价格。SeedRouter 当前费率请以下方实时表格为准。[1]
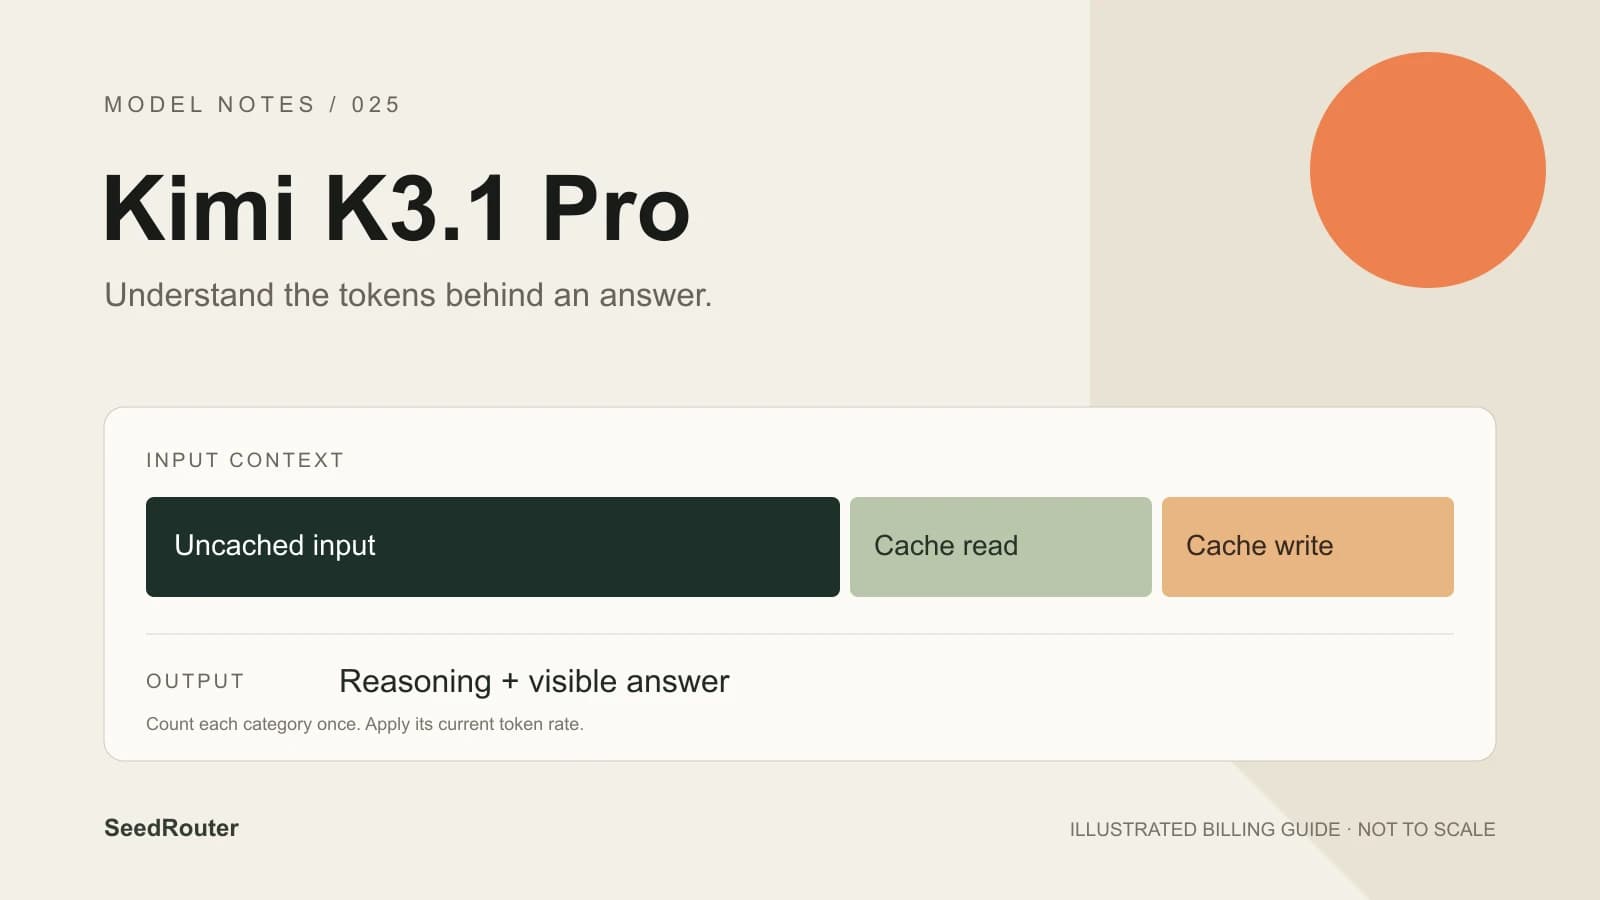
估算请求费用时有两点需要注意。缓存 token 属于提示词的一部分,将它再加到完整输入数上会对同一段文本重复计费。推理 token 属于输出的一部分,因此可见答案的长度可能低估实际计费用量。
GLM-5.3 模型页 汇集 Playground、模型限制和实时价格。本指南解释请求费用的计算方式,不假设缓存命中,也不将示例计算当作实测结果。
SeedRouter 上的 GLM-5.3 当前价格
下表从计费配置读取当前费率。通过本服务发起请求时,应使用这里的费率。
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
请在估算旁记录模型 ID:Default 档的模型 ID 为 glm-5.3。GLM-5.3、GLM-5.3-Flash 和 GLM-5.3-FlashX 是不同模型。名称相似的模型价格不能用来确定你的请求费用。
百万 token 上下文是容量上限,不是固定购买量。包含少量文字的请求无需购买整个上下文窗口。请使用该请求实际返回的输入和输出数量。[2]
哪些 token 应计入费用?
对于 Chat Completions 响应,请读取 usage 中的以下字段:
| 字段 | 含义 |
|---|---|
prompt_tokens | 总输入,包含缓存输入 |
prompt_tokens_details.cached_tokens | 从缓存读取的输入部分 |
completion_tokens | 输出,包含推理 |
total_tokens | 输入加输出;不是第三种计费类别 |
费率以每百万 token 表示时,常规计算方式为:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
假设一次请求的总输入为 10,000 个 token,其中缓存输入为 2,000 个 token,输出为 1,000 个 token。普通输入部分为 8,000 个 token。按上文注明日期的 Z.ai 标价计算,即 (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000,结果为 $0.01612。这是使用厂商费率的算术示例,不是实测请求,也不是本服务的报价。
如果响应单独报告缓存写入,请使用适用的实时费率,并从普通输入中减去该部分单独报告的数量。不要根据文本长度臆测写入数量。API 参考 说明了三种协议的用量表达方式;各自字段名不可互换。
缓存输入是什么意思?
GLM-5.3 文档描述的上下文缓存是自动的。普通 Chat 请求无需声明显式缓存有效期。复用不变的前缀,例如指令加参考材料,可以提供复用机会;修改前缀可能改变命中机会。[3]
具备复用条件不等于已经命中。请从完成的响应读取 prompt_tokens_details.cached_tokens,不要根据看起来重复的文本量估算节省。官方缓存示例中,总提示词为 1,200 个 token,其中 800 个来自缓存;只有剩余 400 个属于普通输入。
厂商价格页另行说明缓存存储暂时免费。这不代表每个缓存请求的推理免费,也不构成固定有效期或重复文本必然命中的保证,更不能据此将其他模型的五分钟和一小时写入计费安排套用到 GLM-5.3。[1]
在你自己的响应提供缓存用量前,请保守估算。为新工作负载做预算时,无缓存计算是实用起点。有代表性结果后,再比较完整任务中的实际未缓存输入、缓存输入与输出。
为什么简短答案也可能消耗大量输出 token
GLM-5.3 始终推理。可选强度为 low、high 和 max,文档默认值为 max。低强度不等于关闭思考。模型不接受 thinking.type: "disabled"。[2]
推理与答案文本共享输出预算。一句回答之前可能进行了大量推理,而过小的输出上限可能让生成在出现有用答案前就停止。判断请求是否满足验收标准前,请检查结束原因或终态。
文档未为这些强度标签设置价格倍率。它们影响模型处理任务的方式;费用由 token 数量决定。若想了解应用中的取舍,请用相同输入和检查标准比较强度设置,并记录完成任务的总费用,包括你选择追加的请求。
输出上限为 131,072 个 token。Chat 请求 schema 未公布默认输出上限;Responses 文档默认值为 65,536。这些数字都不意味着小任务应该请求最大值。请为推理与期望答案留出足够预算,再检查实际用量。
API 计费与 Coding Plan 的区别
Z.ai 的 Coding Plan 是独立的订阅产品。编程工具可以发起 API 请求,但仅凭这一点无法确定费用由哪一余额或订阅支付。
厂商的 API 密钥规则于 2026 年 10 月 16 日调整。新签发的 Standard API 密钥和 Coding Plan 密钥有独立计费类型,更换端点不会改变新密钥的计费类型。较早的 Compatible 密钥采用不同的端点相关规则;检查现有配置时,请使用当前密钥管理指南。[4]
使用 SeedRouter 密钥发起的请求消耗本服务的预付余额,按当前费率计费。外部 Coding Plan 订阅额度不会转移到这里。请在接入记录中一并保存密钥签发方、模型 ID 和费率来源,避免更换客户端后悄然改变费用假设。
首次请求前的常见问题
GLM-5.3 免费吗?
这里的请求按上方实时费率使用预付余额,无需订阅,失败的请求不收费。低 token 费率依然属于按量收费;批量运行前请同时估算输入和输出。
GLM-5.3-Flash 的价格适用吗?
不适用。本指南介绍纯文本 GLM-5.3 旗舰模型。Flash 和 FlashX 有独立的模型身份、能力与价格。请确保请求中的确切模型 ID 与所用费率表一致。
长上下文一定更贵吗?
容量本身不收费。实际输入 token 更多,通常会增加输入用量;缓存命中则可能改变部分输入适用的费率。较长输出也会改变总费用,因此请同时比较请求两端。
如何估算批量任务费用?
从有代表性的任务开始,不要只测一条短提示词。记录每次请求的输入、缓存与输出用量,乘以适用费率,再对整批求和。另行记录每个结果是否通过验收检查;廉价但不完整的答案不算完成工作。
在哪里查看参数?
完整 Chat、Responses 和 Messages 字段表见 GLM-5.3 API 参考。Playground 可在发送前检查请求。先从可核验的问题开始,同时阅读答案与用量。
来源
- Z.ai 价格, 核对日期:2026 年 10 月 29 日。
- GLM-5.3 模型指南, 核对日期:2026 年 10 月 29 日。
- 上下文缓存, 核对日期:2026 年 10 月 29 日。
- API 密钥管理, 核对日期:2026 年 10 月 29 日。