GLM-5.3 가격: 입력, 출력과 캐시 비용
GLM-5.3 토큰 요율, 캐시된 입력과 추론 설정을 비교합니다. 요청 비용을 추정하고 API 사용료와 코딩 구독의 차이를 함께 확인합니다.
Markdown으로 읽기GLM-5.3 가격은 일반 입력, 캐시된 입력과 출력이라는 세 가지 주요 수량으로 결정됩니다. Z.ai가 공개한 정가는 각각 100만 토큰당 $1.40, $0.26, $4.40이며 2026년 10월 29일에 확인했습니다. 이는 제조사 가격입니다. SeedRouter의 현재 요율은 아래 실시간 표를 확인하세요.[1]
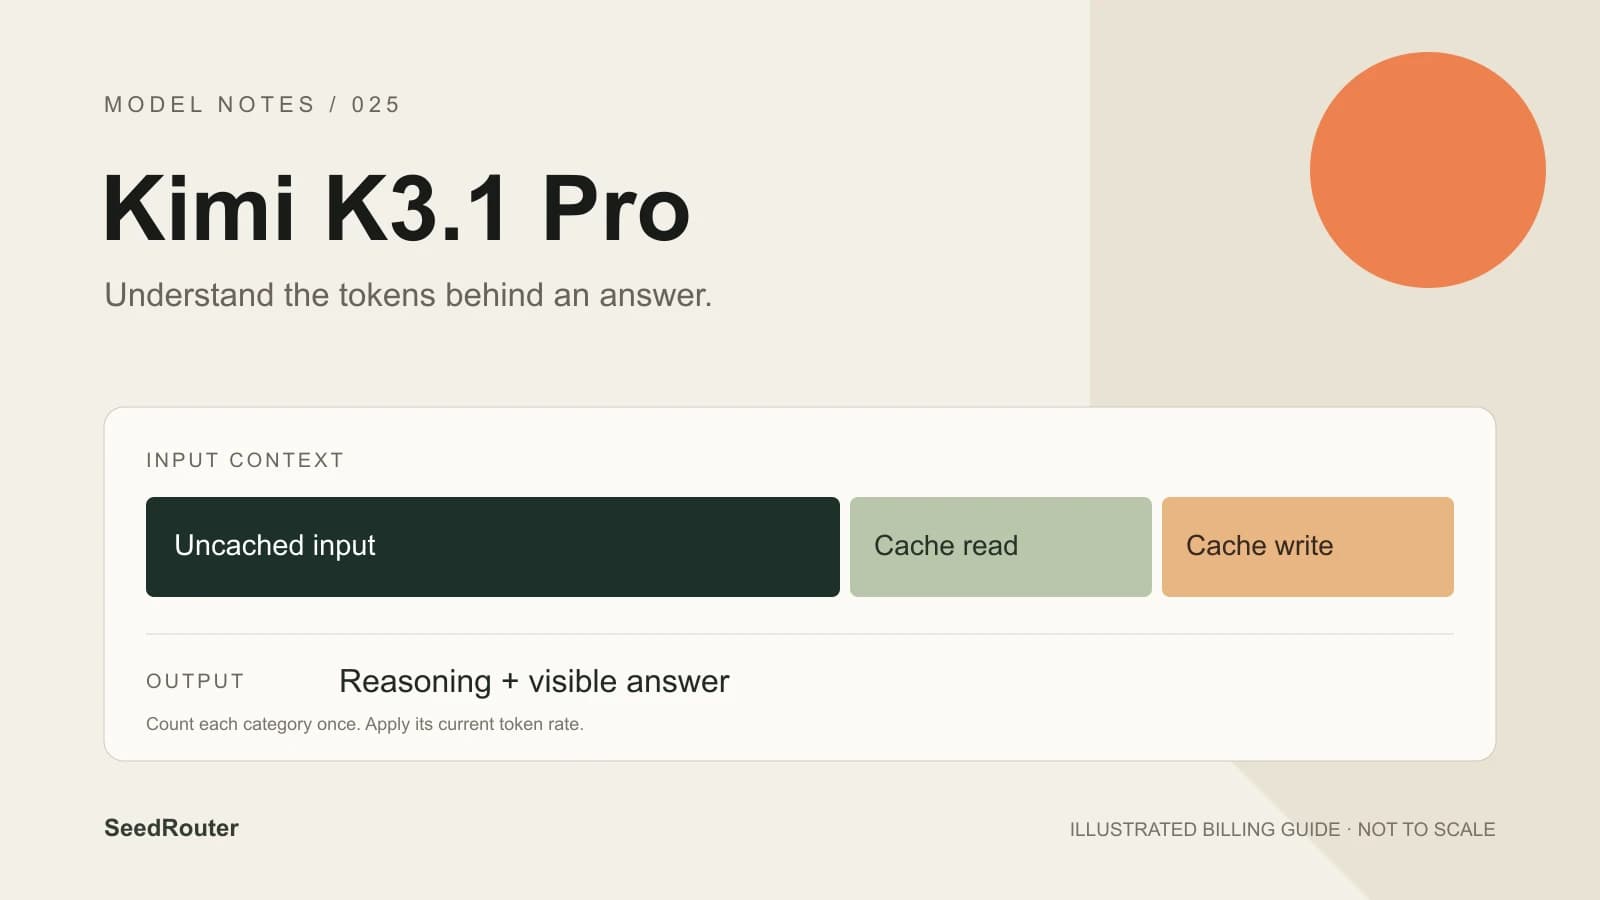
요청 비용을 추정할 때 두 가지를 주의해야 합니다. 캐시된 토큰은 프롬프트에 포함되므로 전체 입력 수에 더하면 같은 텍스트를 두 번 계산하게 됩니다. 추론 토큰은 출력에 포함되므로 보이는 답변 길이만으로는 과금된 작업량을 실제보다 적게 추정할 수 있습니다.
GLM-5.3 모델 페이지에서 Playground, 모델 한도와 실시간 가격을 함께 확인할 수 있습니다. 이 가이드는 캐시 적중을 가정하거나 예시 계산을 측정 결과로 제시하지 않고 요청 비용의 계산 방법을 설명합니다.
SeedRouter의 현재 GLM-5.3 가격
아래 표는 과금 설정에서 현재 요율을 읽어 옵니다. 이 서비스를 통해 보내는 요청에는 이 요율을 사용합니다.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
견적과 함께 모델 ID를 기록하세요. Default 모델 ID는 glm-5.3입니다. GLM-5.3, GLM-5.3-Flash와 GLM-5.3-FlashX는 서로 다른 모델입니다. 이름이 비슷한 모델의 가격으로 요청 비용을 판단할 수 없습니다.
100만 토큰 컨텍스트는 용량 한도이며 정액 구매 단위가 아닙니다. 적은 텍스트를 담은 요청으로 전체 컨텍스트 윈도우를 구매하는 것은 아닙니다. 해당 요청이 실제로 반환한 입력과 출력 수를 사용하세요.[2]
계산에 어떤 토큰을 포함해야 하나요?
Chat Completions 응답에서는 usage 안의 다음 필드를 확인합니다.
| 필드 | 의미 |
|---|---|
prompt_tokens | 캐시된 입력을 포함한 전체 입력 |
prompt_tokens_details.cached_tokens | 캐시에서 제공된 입력 부분 |
completion_tokens | 추론을 포함한 출력 |
total_tokens | 입력과 출력의 합계이며 별도의 세 번째 과금 항목이 아님 |
요율이 100만 토큰당 금액일 때 일반적인 계산은 다음과 같습니다.
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
전체 입력 10,000 토큰, 캐시된 입력 2,000 토큰, 출력 1,000 토큰인 가상의 요청을 생각해 보겠습니다. 일반 입력은 8,000 토큰입니다. 위 날짜의 Z.ai 정가를 적용하면 (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, 즉 $0.01612입니다. 이는 제조사 요율을 사용한 계산 예시이며 측정한 요청이나 이 서비스의 견적이 아닙니다.
응답이 캐시 쓰기를 별도로 보고한다면 해당 실시간 요율을 적용하고 별도로 보고된 부분도 일반 입력에서 차감합니다. 텍스트 길이로 쓰기 수량을 만들어 내지 마세요. API 레퍼런스는 세 프로토콜 형식의 사용량 표시 방법을 설명합니다. 필드 이름은 서로 바꿔 쓸 수 없습니다.
캐시된 입력은 무엇인가요?
GLM-5.3 문서에 명시된 컨텍스트 캐시는 자동으로 동작합니다. 일반 Chat 요청에서 캐시 수명을 명시적으로 선언할 필요가 없습니다. 지시문 뒤에 참고 자료가 이어지는 등 변경되지 않은 접두부를 재사용하면 캐시를 재사용할 수 있습니다. 접두부를 변경하면 적중 가능성도 달라질 수 있습니다.[3]
캐시 사용 조건을 충족했다고 해서 적중한 것은 아닙니다. 익숙해 보이는 텍스트 양으로 절감액을 추정하지 말고 완료된 응답의 prompt_tokens_details.cached_tokens를 확인하세요. 공식 캐싱 예제에서는 전체 프롬프트 1,200 토큰에 캐시된 800 토큰이 포함되어 있으며 나머지 400 토큰만 일반 입력입니다.
제조사 가격 페이지는 캐시 저장을 일시적으로 무료라고 별도 설명합니다. 이 문구가 모든 캐시 요청의 추론을 무료로 만들거나 고정 수명을 정하거나 반복 텍스트의 캐시 적중을 보장하지는 않습니다. 다른 모델의 5분 및 1시간 쓰기 요금 체계를 GLM-5.3 가격에 적용할 근거도 아닙니다.[1]
자체 응답에서 캐시 사용량을 확인하기 전까지는 보수적으로 추정하세요. 새로운 작업의 예산은 캐시가 없다고 계산하는 것부터 시작할 수 있습니다. 대표적인 결과를 확보하면 전체 작업에 걸친 실제 일반 입력, 캐시된 입력과 출력을 비교합니다.
짧은 답변도 출력 토큰을 많이 사용하는 이유
GLM-5.3는 항상 추론합니다. 추론 강도는 low, high, max이며 문서에 명시된 기본값은 max입니다. 낮은 강도가 사고 기능 비활성화를 뜻하지는 않습니다. 모델은 thinking.type: "disabled"를 허용하지 않습니다.[2]
추론과 답변 텍스트는 출력 예산을 공유합니다. 한 문장 답변 전에 상당한 추론을 수행할 수 있으며 출력 한도가 너무 작으면 유용한 답변이 나오기 전에 중단될 수 있습니다. 요청이 승인 기준을 충족했는지 판단하기 전에 종료 사유나 최종 상태를 확인합니다.
이 강도 이름에 연결된 가격 배수는 문서화되어 있지 않습니다. 강도는 모델이 작업에 접근하는 방식에 영향을 주며 요금은 토큰 수로 결정됩니다. 앱에서의 절충점을 이해하려면 동일한 입력과 검증 기준으로 강도를 비교하세요. 추가로 보내기로 한 요청까지 포함하여 작업을 완료하는 전체 비용을 기록합니다.
출력 상한은 131,072 토큰입니다. Chat 요청 스키마에는 기본 출력 한도가 공개되어 있지 않으며 Responses에는 기본값 65,536이 명시되어 있습니다. 어느 값도 작은 작업에 최대 출력을 요청하라는 권장 사항은 아닙니다. 추론과 원하는 답변에 충분한 여유를 주는 예산을 선택한 다음 실제 사용량을 확인합니다.
API 과금과 Coding Plan의 차이
Z.ai의 Coding Plan은 별도의 구독 상품입니다. 코딩 도구가 API 요청을 보낼 수 있지만 그것만으로 어떤 잔액이나 구독에서 비용을 지불하는지 알 수는 없습니다.
제조사의 API 키 규칙은 2026년 10월 16일에 변경되었습니다. 새로 발급된 Standard API 키와 Coding Plan 키는 과금 유형이 분리됩니다. 엔드포인트를 변경해도 새 키의 과금 유형은 바뀌지 않습니다. 이전 Compatible 키에는 엔드포인트에 따른 별도 규칙이 있으므로 기존 설정을 점검할 때는 최신 키 관리 가이드를 확인하세요.[4]
SeedRouter 키로 보낸 요청은 이 서비스의 선불 크레딧과 현재 요율을 사용합니다. 외부 Coding Plan 구독의 할당량은 여기로 이전되지 않습니다. 클라이언트를 바꿨을 때 비용 가정이 의도치 않게 달라지지 않도록 연동 기록에 키 발급처, 모델 ID와 요율 출처를 함께 남깁니다.
첫 요청 전에 확인할 질문
GLM-5.3는 무료인가요?
여기서 보내는 요청은 위 실시간 요율에 따라 선불 크레딧을 사용합니다. 구독은 필수가 아니며 실패한 요청에는 요금이 부과되지 않습니다. 토큰 요율이 낮아도 사용료는 발생하므로 일괄 실행 전에 입력과 출력 모두를 추정합니다.
GLM-5.3-Flash 가격을 적용하나요?
아니요. 이 가이드는 텍스트 전용 GLM-5.3 플래그십 모델을 다룹니다. Flash와 FlashX는 모델 ID, 기능과 가격이 서로 다릅니다. 요청의 정확한 모델 ID와 사용하는 요율 표를 일치시키세요.
컨텍스트가 길면 항상 더 비싼가요?
용량 자체에는 요금이 부과되지 않습니다. 실제 입력 토큰이 많아지면 일반적으로 입력 사용량이 늘어나며 캐시 적중으로 입력 일부에 적용되는 요율이 달라질 수 있습니다. 긴 출력도 총액에 영향을 주므로 요청의 양쪽을 비교합니다.
일괄 작업 비용은 어떻게 추정하나요?
짧은 프롬프트 하나가 아닌 대표적인 작업부터 시작합니다. 요청별 입력, 캐시와 출력 사용량을 기록합니다. 각 수량에 해당 요율을 곱한 다음 전체 작업에 걸쳐 합산합니다. 각 결과가 승인 검증을 통과했는지도 별도로 기록합니다. 저렴하지만 불완전한 답변은 완료한 작업이 아닙니다.
매개변수는 어디에서 확인하나요?
전체 Chat, Responses와 Messages 필드 표는 GLM-5.3 API 레퍼런스를 확인하세요. Playground에서는 전송 전에 요청을 살펴볼 수 있습니다. 검증 가능한 질문부터 시작하고 답변과 함께 사용량을 읽습니다.
출처
- Z.ai 가격, 2026년 10월 29일 확인.
- GLM-5.3 모델 가이드, 2026년 10월 29일 확인.
- 컨텍스트 캐싱, 2026년 10월 29일 확인.
- API 키 관리, 2026년 10월 29일 확인.