Giá GLM-5.3: Chi phí đầu vào, đầu ra và bộ nhớ đệm
So sánh giá token GLM-5.3, đầu vào từ bộ nhớ đệm và mức suy luận. Ước tính phí yêu cầu, phân biệt API với thuê bao lập trình.
Đọc dạng MarkdownGiá GLM-5.3 dựa trên ba đại lượng chính: đầu vào thông thường, đầu vào từ bộ nhớ đệm và đầu ra. Giá niêm yết Z.ai công bố lần lượt là $1,40, $0,26 và $4,40 cho mỗi triệu token, được kiểm tra ngày 29 tháng 10 năm 2026. Đây là giá của nhà sản xuất. Dùng bảng trực tiếp bên dưới để xem giá hiện tại trên SeedRouter.[1]
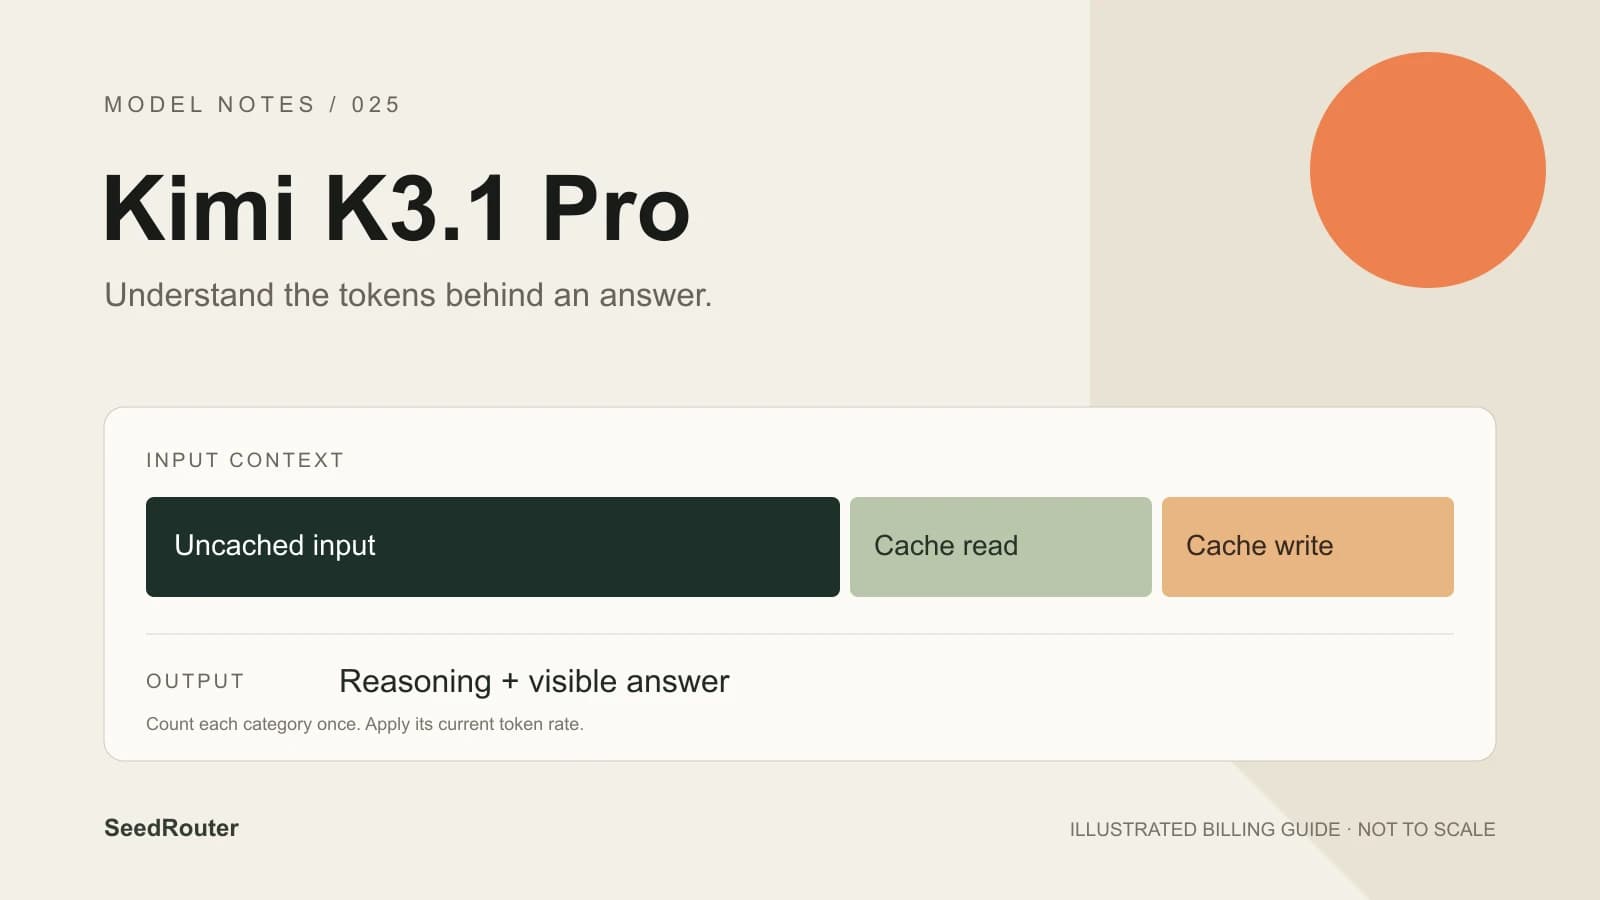
Có hai điểm cần chú ý khi ước tính yêu cầu. Token từ bộ nhớ đệm thuộc prompt, nên cộng chúng vào tổng đầu vào sẽ tính cùng một văn bản hai lần. Token suy luận thuộc đầu ra, nên độ dài câu trả lời hiển thị có thể không phản ánh hết phần công việc đã tính phí.
Trang mô hình GLM-5.3 kết hợp Playground, giới hạn mô hình và giá hiện tại. Bài viết này giải thích phép tính cho một yêu cầu, không giả định trúng bộ nhớ đệm hay trình bày phép tính minh họa như kết quả đo thực tế.
Giá GLM-5.3 hiện tại trên SeedRouter
Bảng sau lấy giá hiện tại từ cấu hình tính phí. Đây là nguồn giá cần dùng cho yêu cầu qua dịch vụ này.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
Ghi ID mô hình cạnh ước tính: ID mô hình Default là glm-5.3. GLM-5.3, GLM-5.3-Flash và GLM-5.3-FlashX là các mô hình khác nhau. Giá gắn với tên tương tự không xác định được yêu cầu của bạn sẽ tốn bao nhiêu.
Ngữ cảnh một triệu token là giới hạn dung lượng, không phải gói mua cố định. Yêu cầu chứa ít văn bản không mua toàn bộ cửa sổ ngữ cảnh. Dùng số đầu vào và đầu ra thực tế trả về cho yêu cầu đó.[2]
Những token nào được đưa vào phép tính?
Với phản hồi Chat Completions, đọc các trường sau trong usage:
| Trường | Ý nghĩa |
|---|---|
prompt_tokens | Tổng đầu vào, gồm đầu vào từ bộ nhớ đệm |
prompt_tokens_details.cached_tokens | Phần đầu vào được lấy từ bộ nhớ đệm |
completion_tokens | Đầu ra, gồm suy luận |
total_tokens | Đầu vào cộng đầu ra; không phải loại phí thứ ba |
Với giá theo mỗi triệu token, phép tính thông thường là:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
Xét yêu cầu giả định có tổng đầu vào 10.000 token, trong đó 2.000 token từ bộ nhớ đệm, và 1.000 token đầu ra. Phần đầu vào thông thường là 8.000 token. Theo giá niêm yết Z.ai tại ngày nêu trên, phép tính là (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, tức $0,01612. Đây là ví dụ số học dùng giá nhà sản xuất, không phải yêu cầu đo thực tế hay báo giá của dịch vụ này.
Nếu phản hồi báo cáo riêng phần ghi bộ nhớ đệm, áp dụng giá hiện tại tương ứng và trừ cả phần báo cáo riêng đó khỏi đầu vào thông thường. Không suy ra số token ghi từ độ dài văn bản. Tài liệu API giải thích cách ba định dạng giao thức thể hiện mức sử dụng; tên trường không thể dùng thay thế cho nhau.
Đầu vào từ bộ nhớ đệm nghĩa là gì?
Bộ nhớ đệm ngữ cảnh GLM-5.3 được mô tả là tự động. Bạn không cần khai báo thời gian lưu bộ nhớ đệm tường minh trong yêu cầu Chat thông thường. Dùng lại tiền tố không đổi, chẳng hạn chỉ dẫn theo sau bởi tài liệu tham khảo, tạo điều kiện tái sử dụng; thay đổi tiền tố có thể thay đổi khả năng trúng bộ nhớ đệm.[3]
Đủ điều kiện không phải bằng chứng đã trúng bộ nhớ đệm. Đọc prompt_tokens_details.cached_tokens từ phản hồi hoàn tất thay vì ước tính tiết kiệm theo lượng văn bản trông quen thuộc. Ví dụ chính thức có 800 token từ bộ nhớ đệm trong tổng 1.200 token prompt; chỉ 400 token còn lại là đầu vào thông thường.
Trang giá của nhà sản xuất mô tả riêng việc lưu bộ nhớ đệm là tạm thời miễn phí. Điều này không khiến mọi yêu cầu có bộ nhớ đệm trở thành suy luận miễn phí, không xác lập thời gian lưu cố định hay bảo đảm văn bản lặp lại sẽ trúng bộ nhớ đệm. Cũng không có cơ sở áp dụng lịch ghi năm phút và một giờ của mô hình khác vào giá GLM-5.3.[1]
Ước tính thận trọng cho đến khi phản hồi của bạn cung cấp mức sử dụng bộ nhớ đệm. Khi lập ngân sách cho tác vụ mới, phép tính không dùng bộ nhớ đệm là điểm khởi đầu hữu ích. Khi có kết quả đại diện, so sánh đầu vào không lưu đệm, đầu vào từ bộ nhớ đệm và đầu ra thực tế trên các tác vụ hoàn chỉnh.
Vì sao câu trả lời ngắn có thể dùng nhiều token đầu ra
GLM-5.3 luôn suy luận. Các mức là low, high và max, với max là mặc định được công bố. Mức thấp không có nghĩa là tắt suy luận. Mô hình không nhận thinking.type: "disabled".[2]
Suy luận và văn bản trả lời dùng chung ngân sách đầu ra. Câu trả lời một câu có thể đến sau quá trình suy luận dài, còn giới hạn đầu ra quá nhỏ có thể dừng trước khi có câu trả lời hữu ích. Kiểm tra lý do kết thúc hoặc trạng thái cuối trước khi xác định yêu cầu đáp ứng tiêu chí nghiệm thu.
Không có hệ số nhân giá được công bố cho các nhãn mức suy luận này. Chúng ảnh hưởng cách mô hình xử lý tác vụ; số token quyết định phí. So sánh các mức trên cùng đầu vào và tiêu chí kiểm tra để hiểu sự đánh đổi cho ứng dụng. Ghi tổng chi phí hoàn thành tác vụ, gồm mọi yêu cầu bổ sung bạn chọn thực hiện.
Giới hạn đầu ra là 131.072 token. Schema yêu cầu Chat không công bố giới hạn đầu ra mặc định; Responses công bố mặc định 65.536. Cả hai con số đều không phải khuyến nghị yêu cầu tối đa cho tác vụ nhỏ. Chọn ngân sách đủ cho suy luận và câu trả lời mong muốn, rồi kiểm tra mức sử dụng thực tế.
Tính phí API và Coding Plan
Coding Plan của Z.ai là sản phẩm thuê bao riêng. Công cụ lập trình có thể gửi yêu cầu API, nhưng điều đó chưa xác định số dư hoặc thuê bao nào chi trả.
Quy tắc khóa API của nhà sản xuất thay đổi ngày 16 tháng 10 năm 2026. Khóa Standard API và khóa Coding Plan mới cấp có loại tính phí riêng. Đổi endpoint không thay đổi loại tính phí của khóa mới. Khóa Compatible cũ có quy tắc khác tùy endpoint, nên dùng hướng dẫn quản lý khóa hiện tại để kiểm tra cấu hình có sẵn.[4]
Yêu cầu bằng khóa SeedRouter dùng số dư trả trước và giá hiện tại của dịch vụ này. Thuê bao Coding Plan bên ngoài không chuyển hạn mức sang đây. Ghi cùng nhau bên cấp khóa, ID mô hình và nguồn giá trong ghi chú tích hợp để việc đổi client không âm thầm thay đổi giả định chi phí.
Câu hỏi trước yêu cầu đầu tiên
GLM-5.3 có miễn phí không?
Yêu cầu ở đây dùng số dư trả trước theo giá hiện tại ở trên. Không bắt buộc đăng ký thuê bao và yêu cầu thất bại không bị tính phí. Giá token thấp vẫn là phí sử dụng; ước tính cả đầu vào và đầu ra trước khi chạy hàng loạt.
Có áp dụng giá GLM-5.3-Flash không?
Không. Bài viết này nói về mô hình chủ lực GLM-5.3 chỉ nhận văn bản. Flash và FlashX có định danh, khả năng và giá riêng. Đối chiếu chính xác ID mô hình trong yêu cầu với bảng giá bạn dùng.
Ngữ cảnh dài có luôn đắt hơn không?
Bản thân dung lượng không bị tính phí. Nhiều token đầu vào thực tế hơn thường làm tăng mức sử dụng đầu vào, còn trúng bộ nhớ đệm có thể thay đổi giá áp dụng cho một phần đầu vào. Đầu ra dài cũng thay đổi tổng phí, nên so sánh cả hai phía của yêu cầu.
Nên ước tính một lô yêu cầu thế nào?
Bắt đầu bằng các tác vụ đại diện, thay vì chỉ một prompt ngắn. Ghi mức sử dụng đầu vào, bộ nhớ đệm và đầu ra cho từng yêu cầu. Nhân các lượng đó với giá tương ứng rồi cộng cả lô. Ghi riêng kết quả có vượt qua kiểm tra nghiệm thu hay không; câu trả lời rẻ nhưng chưa đầy đủ không phải công việc đã hoàn thành.
Xem tham số ở đâu?
Dùng tài liệu API GLM-5.3 để xem bảng trường Chat, Responses và Messages đầy đủ. Playground cho phép kiểm tra yêu cầu trước khi gửi. Bắt đầu bằng câu hỏi có thể kiểm chứng và đọc mức sử dụng cùng câu trả lời.
Nguồn
- Giá Z.ai, kiểm tra ngày 29 tháng 10 năm 2026.
- Hướng dẫn mô hình GLM-5.3, kiểm tra ngày 29 tháng 10 năm 2026.
- Bộ nhớ đệm ngữ cảnh, kiểm tra ngày 29 tháng 10 năm 2026.
- Quản lý khóa API, kiểm tra ngày 29 tháng 10 năm 2026.