Prezzi GLM-5.3: costi di input, output e cache
Confronta tariffe dei token GLM-5.3, input in cache e ragionamento. Stima il costo delle richieste e distingui API e abbonamento di programmazione.
Leggi in MarkdownI prezzi di GLM-5.3 dipendono da tre quantità principali: input ordinario, input in cache e output. Le tariffe di listino pubblicate da Z.ai sono rispettivamente $1,40, $0,26 e $4,40 per milione di token, verificate il 29 ottobre 2026. Sono i prezzi del produttore. Per le tariffe attuali di SeedRouter usa la tabella aggiornata qui sotto.[1]
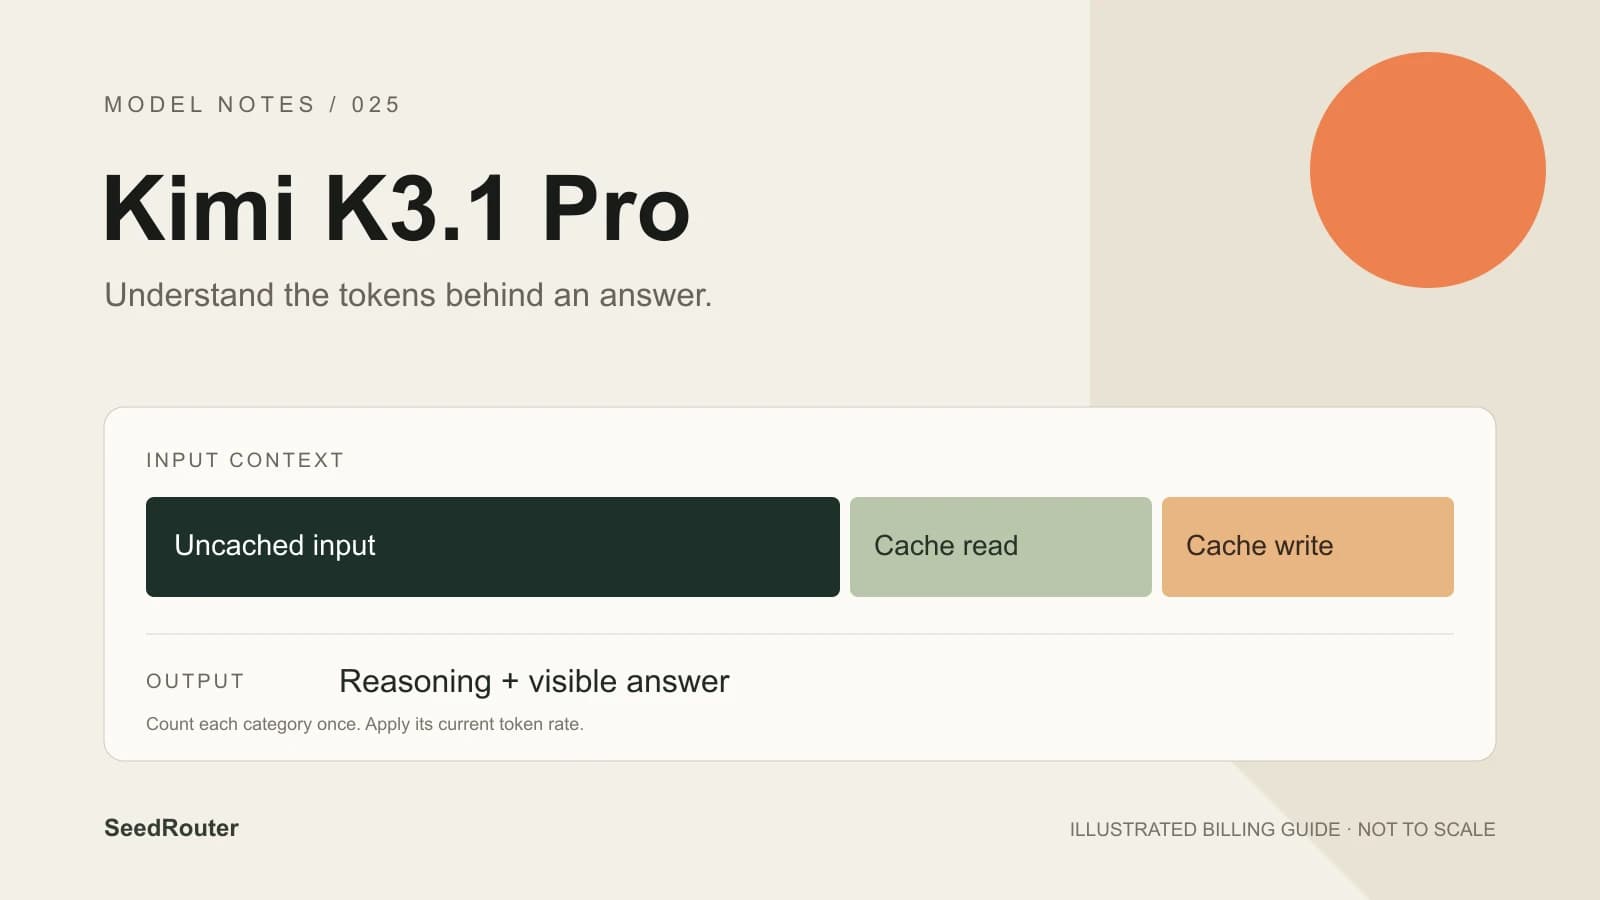
Due dettagli contano nella stima di una richiesta. I token in cache fanno parte del prompt: aggiungerli al conteggio totale dell’input addebita due volte lo stesso testo. I token di ragionamento fanno parte dell’output, quindi la lunghezza della risposta visibile può sottostimare il lavoro fatturato.
La pagina del modello GLM-5.3 riunisce Playground, limiti del modello e prezzi attuali. Questa guida spiega il calcolo di una richiesta, senza presumere un riscontro nella cache né presentare un calcolo indicativo come un risultato misurato.
Prezzi attuali di GLM-5.3 su SeedRouter
La tabella seguente legge le tariffe attuali dalle impostazioni di fatturazione. È la fonte delle tariffe da usare per le richieste effettuate tramite questo servizio.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
Conserva l’ID del modello accanto alla stima: l’ID del modello Default è glm-5.3. GLM-5.3, GLM-5.3-Flash e GLM-5.3-FlashX sono modelli diversi. Un prezzo associato a un nome simile non determina il costo della tua richiesta.
Il contesto da un milione di token è un limite di capacità, non un acquisto fisso. Una richiesta con poco testo non acquista l’intera finestra di contesto. Usa i conteggi di input e output effettivamente restituiti per quella richiesta.[2]
Quali token entrano nel calcolo?
Per una risposta Chat Completions, leggi questi campi all’interno di usage:
| Campo | Significato |
|---|---|
prompt_tokens | Input totale, incluso l’input in cache |
prompt_tokens_details.cached_tokens | La porzione di input servita dalla cache |
completion_tokens | Output, incluso il ragionamento |
total_tokens | Input più output; non è una terza categoria di fatturazione |
Con tariffe espresse per milione di token, il calcolo ordinario è:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
Considera una richiesta ipotetica con 10.000 token di input totali, 2.000 token di input in cache e 1.000 token di output. La porzione di input ordinario è di 8.000 token. Con le tariffe di listino Z.ai datate sopra, il calcolo è (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, ossia $0,01612. È un esempio aritmetico con le tariffe del produttore, non una richiesta misurata né un preventivo per questo servizio.
Se una risposta segnala separatamente le scritture della cache, segui la tariffa attuale applicabile e sottrai anche quella porzione dall’input ordinario. Non ricavare un conteggio di scrittura dalla lunghezza del testo. Il riferimento API spiega come i tre formati di protocollo esprimono l’utilizzo; i nomi dei campi non sono intercambiabili.
Cosa significa input in cache?
La cache del contesto documentata per GLM-5.3 è automatica. Non devi dichiarare una durata esplicita della cache in una normale richiesta Chat. Riutilizzare un prefisso invariato, ad esempio istruzioni seguite da materiale di riferimento, rende possibile il riuso; modificare quel prefisso può cambiare la possibilità di un riscontro.[3]
L’idoneità non prova un riscontro. Leggi prompt_tokens_details.cached_tokens nella risposta completata invece di stimare il risparmio dalla quantità di testo che sembra familiare. L’esempio ufficiale di cache include 800 token in cache in un totale di 1.200 token di prompt; solo i restanti 400 sono input ordinario.
La pagina prezzi del produttore descrive separatamente l’archiviazione della cache come temporaneamente gratuita. Questo non rende gratuita l’inferenza di ogni richiesta in cache, non stabilisce una durata fissa e non garantisce che il testo ripetuto trovi riscontro nella cache. Non giustifica nemmeno l’applicazione ai prezzi di GLM-5.3 delle tariffe di scrittura a cinque minuti e un’ora di un altro modello.[1]
Mantieni stime prudenti finché le tue risposte non forniscono dati di utilizzo della cache. Per un nuovo carico di lavoro, un calcolo senza cache offre un punto di partenza utile. Quando disponi di risultati rappresentativi, confronta input effettivo non in cache, input in cache e output su compiti completi.
Perché una risposta breve può usare molti token di output
GLM-5.3 ragiona sempre. Le opzioni di sforzo sono low, high e max, con max come valore predefinito documentato. Lo sforzo basso non disattiva il ragionamento. Il modello non accetta thinking.type: "disabled".[2]
Ragionamento e testo della risposta condividono il budget di output. Una risposta di una frase può seguire un ragionamento esteso, mentre un limite di output troppo basso può interrompere la generazione prima che appaia una risposta utile. Controlla il motivo di conclusione o lo stato finale prima di decidere che la richiesta soddisfa i criteri di accettazione.
Non è documentato alcun moltiplicatore di prezzo associato a queste etichette di sforzo. Influenzano il modo in cui il modello affronta un compito; sono i conteggi dei token a determinare l’addebito. Confronta le impostazioni di sforzo con gli stessi input e verifiche per capire il compromesso nella tua applicazione. Registra il costo totale del completamento di un compito, incluse eventuali richieste aggiuntive che scegli di effettuare.
Il limite massimo di output è di 131.072 token. Chat non ha un limite predefinito di output pubblicato nello schema della richiesta; Responses documenta un valore predefinito di 65.536. Nessuno dei due numeri consiglia di richiedere il massimo per un piccolo compito. Scegli un budget che lasci spazio sufficiente al ragionamento e alla risposta desiderata, poi esamina l’utilizzo effettivo.
Fatturazione API e Coding Plan
Il Coding Plan di Z.ai è un prodotto in abbonamento separato. Uno strumento di programmazione può effettuare richieste API, ma questo da solo non stabilisce quale saldo o abbonamento le paghi.
Le regole delle chiavi API del produttore sono cambiate il 16 ottobre 2026. Le nuove chiavi Standard API e Coding Plan hanno tipi di fatturazione separati. Cambiare endpoint non cambia il tipo di fatturazione di una nuova chiave. Le vecchie chiavi Compatible hanno regole diverse dipendenti dall’endpoint: consulta la guida attuale alla gestione delle chiavi quando verifichi una configurazione esistente.[4]
Le richieste con una chiave SeedRouter usano il credito prepagato e le tariffe attuali di questo servizio. Un abbonamento Coding Plan esterno non trasferisce qui la propria quota. Tieni insieme emittente della chiave, ID del modello e fonte delle tariffe negli appunti di integrazione, affinché un cambio di client non modifichi silenziosamente le ipotesi sui costi.
Domande prima della prima richiesta
GLM-5.3 è gratuito?
Le richieste qui usano credito prepagato alle tariffe attuali indicate sopra. Non è richiesto un abbonamento e le richieste non riuscite non vengono addebitate. Una tariffa bassa dei token resta un costo a consumo; stima sia input sia output prima di eseguire un lotto.
Si applicano i prezzi di GLM-5.3-Flash?
No. Questa guida riguarda il modello di punta GLM-5.3, che accetta solo testo. Flash e FlashX hanno identità, capacità e prezzi propri. Associa l’esatto ID del modello della richiesta alla tabella delle tariffe utilizzata.
Un contesto lungo costa sempre di più?
La capacità in sé non viene addebitata. Più token effettivi di input generalmente aumentano l’utilizzo dell’input, mentre i riscontri nella cache possono cambiare la tariffa applicata a una sua porzione. Anche un output lungo cambia il totale: confronta entrambi i lati della richiesta.
Come stimare un lotto di richieste?
Inizia con compiti rappresentativi, non solo con un breve prompt. Registra l’utilizzo di input, cache e output di ogni richiesta. Moltiplica queste quantità per le tariffe applicabili, poi somma i risultati del lotto. Registra separatamente se ogni risultato ha superato le verifiche di accettazione; risposte economiche ma incomplete non sono lavoro completato.
Dove posso esaminare i parametri?
Usa il riferimento API GLM-5.3 per le tabelle complete dei campi Chat, Responses e Messages. Il Playground consente di esaminare una richiesta prima di inviarla. Inizia con una domanda verificabile e leggi l’utilizzo insieme alla risposta.
Fonti
- Prezzi Z.ai, verificati il 29 ottobre 2026.
- Guida al modello GLM-5.3, verificata il 29 ottobre 2026.
- Cache del contesto, verificata il 29 ottobre 2026.
- Gestione delle chiavi API, verificata il 29 ottobre 2026.