Precios de GLM-5.3: costes de entrada, salida y caché
Compara las tarifas de GLM-5.3, la entrada en caché y el razonamiento. Calcula el coste de una solicitud y distingue la API de una suscripción de programación.
Leer en MarkdownLos precios de GLM-5.3 tienen tres componentes principales: entrada ordinaria, entrada en caché y salida. Las tarifas de lista publicadas por Z.ai son de $1,40, $0,26 y $4,40 por millón de tokens, respectivamente, consultadas el 29 de octubre de 2026. Son precios del fabricante. Consulta la tabla dinámica de abajo para conocer las tarifas actuales de SeedRouter.[1]
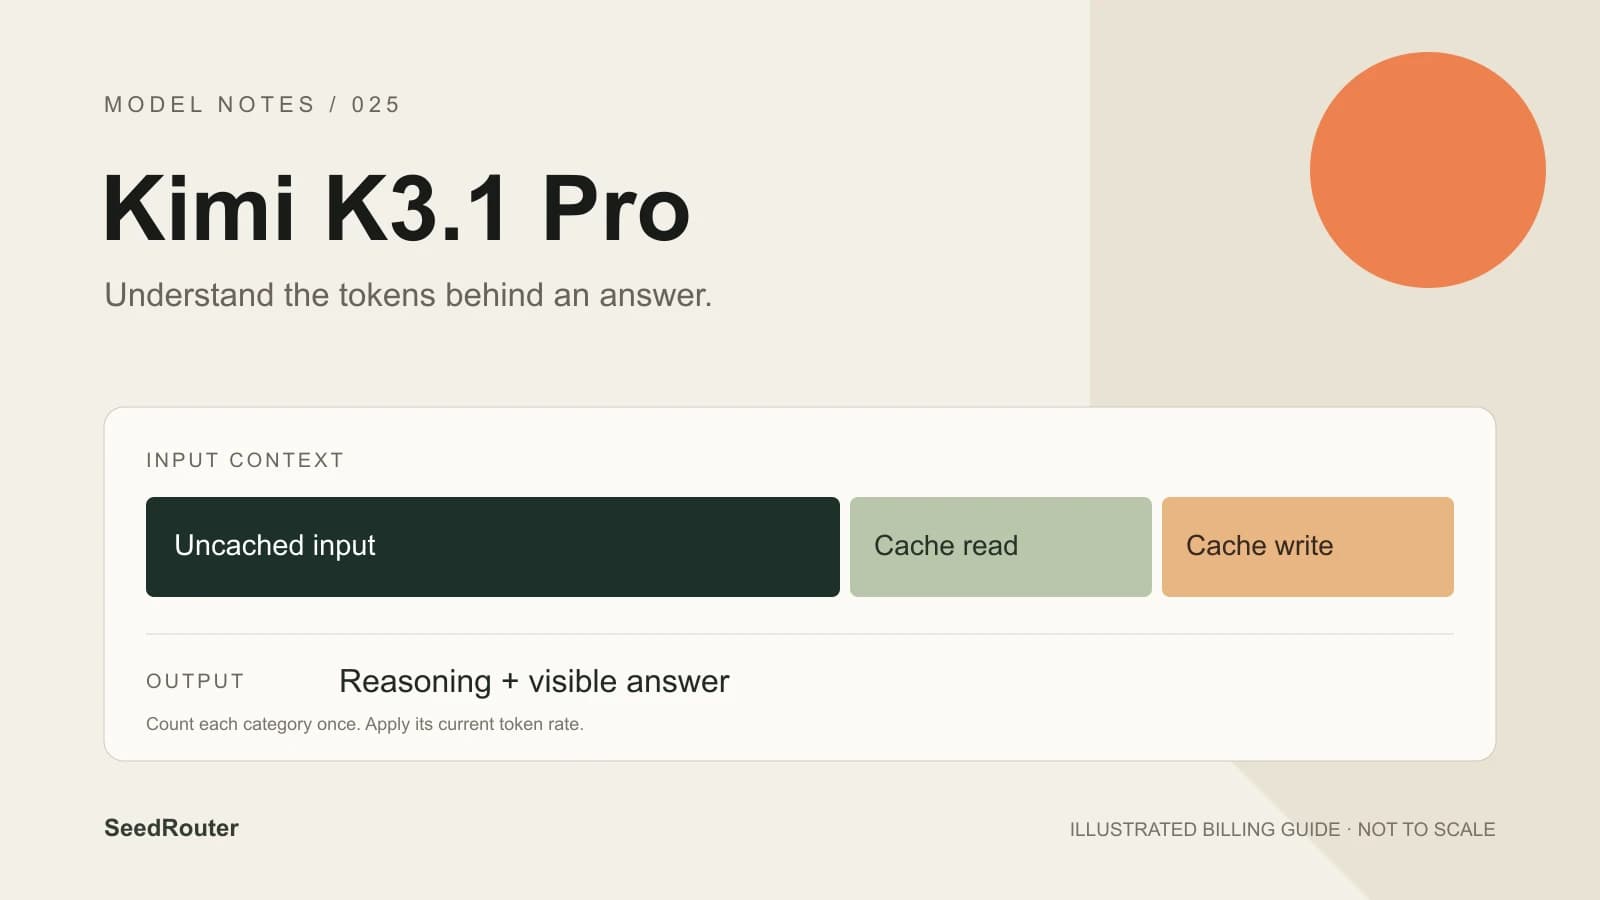
Al estimar una solicitud hay dos detalles esenciales. Los tokens en caché forman parte del prompt; sumarlos al recuento total de entrada equivale a cobrar dos veces el mismo texto. Los tokens de razonamiento forman parte de la salida, de modo que la longitud de la respuesta visible puede subestimar el trabajo facturado.
La página del modelo GLM-5.3 reúne el Playground, los límites del modelo y los precios actuales. Esta guía explica el cálculo de una solicitud, sin dar por hecho un acierto de caché ni presentar un ejemplo de cálculo como un resultado medido.
Precios actuales de GLM-5.3 en SeedRouter
La siguiente tabla obtiene las tarifas actuales de la configuración de facturación. Es la fuente de tarifas que debes utilizar para las solicitudes realizadas a través de este servicio.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
Anota el ID del modelo junto a tu estimación: el ID del modelo Default es glm-5.3. GLM-5.3, GLM-5.3-Flash y GLM-5.3-FlashX son modelos diferentes. El precio asociado a un nombre parecido no determina cuánto costará tu solicitud.
El contexto de un millón de tokens es un límite de capacidad, no una compra fija. Una solicitud con poco texto no compra toda la ventana de contexto. Utiliza los recuentos de entrada y salida realmente devueltos para esa solicitud.[2]
¿Qué tokens se incluyen en el cálculo?
En una respuesta de Chat Completions, consulta estos campos dentro de usage:
| Campo | Significado |
|---|---|
prompt_tokens | Entrada total, incluida la entrada en caché |
prompt_tokens_details.cached_tokens | Parte de la entrada servida desde la caché |
completion_tokens | Salida, incluido el razonamiento |
total_tokens | Entrada más salida; no es una tercera categoría de facturación |
Con tarifas expresadas por millón de tokens, el cálculo ordinario es:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
Imagina una solicitud hipotética con 10.000 tokens de entrada total, 2.000 de entrada en caché y 1.000 de salida. La entrada ordinaria comprende 8.000 tokens. Con las tarifas de lista de Z.ai de la fecha indicada, el cálculo es (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, es decir, $0,01612. Es un ejemplo aritmético con tarifas del fabricante, no una solicitud medida ni un presupuesto de este servicio.
Si una respuesta registra escrituras de caché por separado, aplica la tarifa actual correspondiente y resta también esa parte de la entrada ordinaria. No deduzcas un recuento de escritura a partir de la longitud del texto. La referencia de la API explica cómo expresan el uso los tres formatos de protocolo; sus nombres de campo no son intercambiables.
¿Qué significa entrada en caché?
La caché de contexto documentada de GLM-5.3 es automática. No necesitas declarar una duración explícita de caché en una solicitud Chat ordinaria. Reutilizar un prefijo sin cambios, como instrucciones seguidas de material de referencia, permite su reutilización; modificarlo puede cambiar la posibilidad de obtener un acierto.[3]
Que el contenido sea apto para caché no demuestra un acierto. Consulta prompt_tokens_details.cached_tokens en la respuesta completada en lugar de estimar el ahorro según cuánto texto te resulte familiar. El ejemplo oficial de caché incluye 800 tokens en caché dentro de 1.200 tokens totales del prompt; solo los 400 restantes son entrada ordinaria.
La página de precios del fabricante describe por separado el almacenamiento de caché como temporalmente gratuito. Esa afirmación no convierte cada solicitud con caché en inferencia gratuita, no establece una duración fija ni garantiza que el texto repetido encuentre un acierto. Tampoco justifica aplicar a los precios de GLM-5.3 los periodos de escritura de cinco minutos y una hora de otro modelo.[1]
Mantén estimaciones prudentes hasta que tus propias respuestas proporcionen datos de uso de caché. Al presupuestar una carga de trabajo nueva, un cálculo sin caché ofrece un punto de partida útil. Cuando tengas resultados representativos, compara la entrada real sin caché, la entrada en caché y la salida de tareas completas.
Por qué una respuesta breve puede consumir muchos tokens de salida
GLM-5.3 siempre razona. Sus opciones de esfuerzo son low, high y max, con max como valor predeterminado documentado. Un esfuerzo bajo no significa que el razonamiento esté desactivado. El modelo no acepta thinking.type: "disabled".[2]
El razonamiento y el texto de la respuesta comparten el presupuesto de salida. Una respuesta de una sola frase puede requerir un razonamiento considerable, mientras que un límite de salida demasiado bajo puede detener la generación antes de que aparezca una respuesta útil. Comprueba el motivo de finalización o el estado terminal antes de decidir que una solicitud cumplió tus criterios de aceptación.
No hay ningún multiplicador de precio documentado asociado a estas etiquetas de esfuerzo. Influyen en cómo aborda el modelo una tarea; los recuentos de tokens determinan la factura. Compara los ajustes de esfuerzo con las mismas entradas y comprobaciones si quieres comprender sus ventajas e inconvenientes para tu aplicación. Registra el coste total de completar una tarea, incluidas las solicitudes adicionales que decidas realizar.
El límite de salida es de 131.072 tokens. Chat no publica un límite de salida predeterminado en su esquema de solicitud; Responses documenta un valor predeterminado de 65.536. Ninguna cifra recomienda solicitar el máximo para una tarea pequeña. Elige un presupuesto que deje espacio suficiente para el razonamiento y la respuesta deseada, y revisa después el uso real.
Facturación de la API frente a un Coding Plan
El Coding Plan de Z.ai es un producto de suscripción independiente. Una herramienta de programación puede realizar solicitudes a la API, pero eso por sí solo no determina qué saldo o suscripción las paga.
Las reglas de claves API del fabricante cambiaron el 16 de octubre de 2026. Las nuevas claves Standard API y Coding Plan tienen tipos de facturación separados. Cambiar el endpoint no cambia el tipo de facturación de una clave nueva. Las claves Compatible anteriores tienen reglas diferentes según el endpoint; consulta la guía actual de gestión de claves al revisar una configuración existente.[4]
Las solicitudes realizadas con una clave de SeedRouter utilizan el saldo de prepago y las tarifas actuales de este servicio. Una suscripción externa a Coding Plan no transfiere aquí su cuota. Anota juntos el emisor de la clave, el ID del modelo y la fuente de tarifas en tus notas de integración, para que un cambio de cliente no altere inadvertidamente tus supuestos de costes.
Preguntas antes de tu primera solicitud
¿GLM-5.3 es gratis?
Las solicitudes aquí utilizan saldo de prepago según las tarifas actuales de arriba. No se requiere suscripción y las solicitudes fallidas no se cobran. Una tarifa baja por token sigue siendo un cargo por uso; estima tanto la entrada como la salida antes de ejecutar un lote.
¿Se aplican los precios de GLM-5.3-Flash?
No. Esta guía trata del modelo insignia GLM-5.3, que solo admite texto. Flash y FlashX tienen sus propias identidades, capacidades y precios. Comprueba que el ID exacto del modelo de tu solicitud coincide con la tabla de tarifas que utilizas.
¿Un contexto largo siempre cuesta más?
La capacidad en sí no se cobra. Más tokens reales de entrada suelen aumentar el uso de entrada, mientras que los aciertos de caché pueden cambiar la tarifa aplicable a una parte de ella. Una salida larga también cambia el total; compara ambos lados de la solicitud.
¿Cómo calculo el coste de un lote?
Empieza con tareas representativas, no solo con un prompt breve. Registra el uso de entrada, caché y salida de cada solicitud. Multiplica esas cantidades por las tarifas aplicables y suma el lote. Registra por separado si cada resultado superó tus comprobaciones de aceptación; las respuestas baratas pero incompletas no son trabajo terminado.
¿Dónde puedo consultar los parámetros?
Utiliza la referencia de la API de GLM-5.3 para ver las tablas completas de campos de Chat, Responses y Messages. El Playground permite revisar una solicitud antes de enviarla. Empieza con una pregunta que puedas verificar y lee su uso junto a la respuesta.
Fuentes
- Precios de Z.ai, consultados el 29 de octubre de 2026.
- Guía del modelo GLM-5.3, consultada el 29 de octubre de 2026.
- Caché de contexto, consultada el 29 de octubre de 2026.
- Gestión de claves API, consultada el 29 de octubre de 2026.