GLM-5.3 Preise: Eingabe, Ausgabe und Cache-Kosten
Vergleichen Sie GLM-5.3 Tokenpreise, gecachte Eingabe und Reasoning. Berechnen Sie Anfragekosten und unterscheiden Sie API-Nutzung vom Coding-Abo.
Als Markdown lesenDie Preise für GLM-5.3 umfassen drei Hauptmengen: gewöhnliche Eingabe, gecachte Eingabe und Ausgabe. Die veröffentlichten Listenpreise von Z.ai betragen jeweils $1,40, $0,26 und $4,40 pro Million Token, geprüft am 29. Oktober 2026. Dies sind Herstellerpreise. Die aktuellen Tarife auf SeedRouter finden Sie in der Tabelle unten.[1]
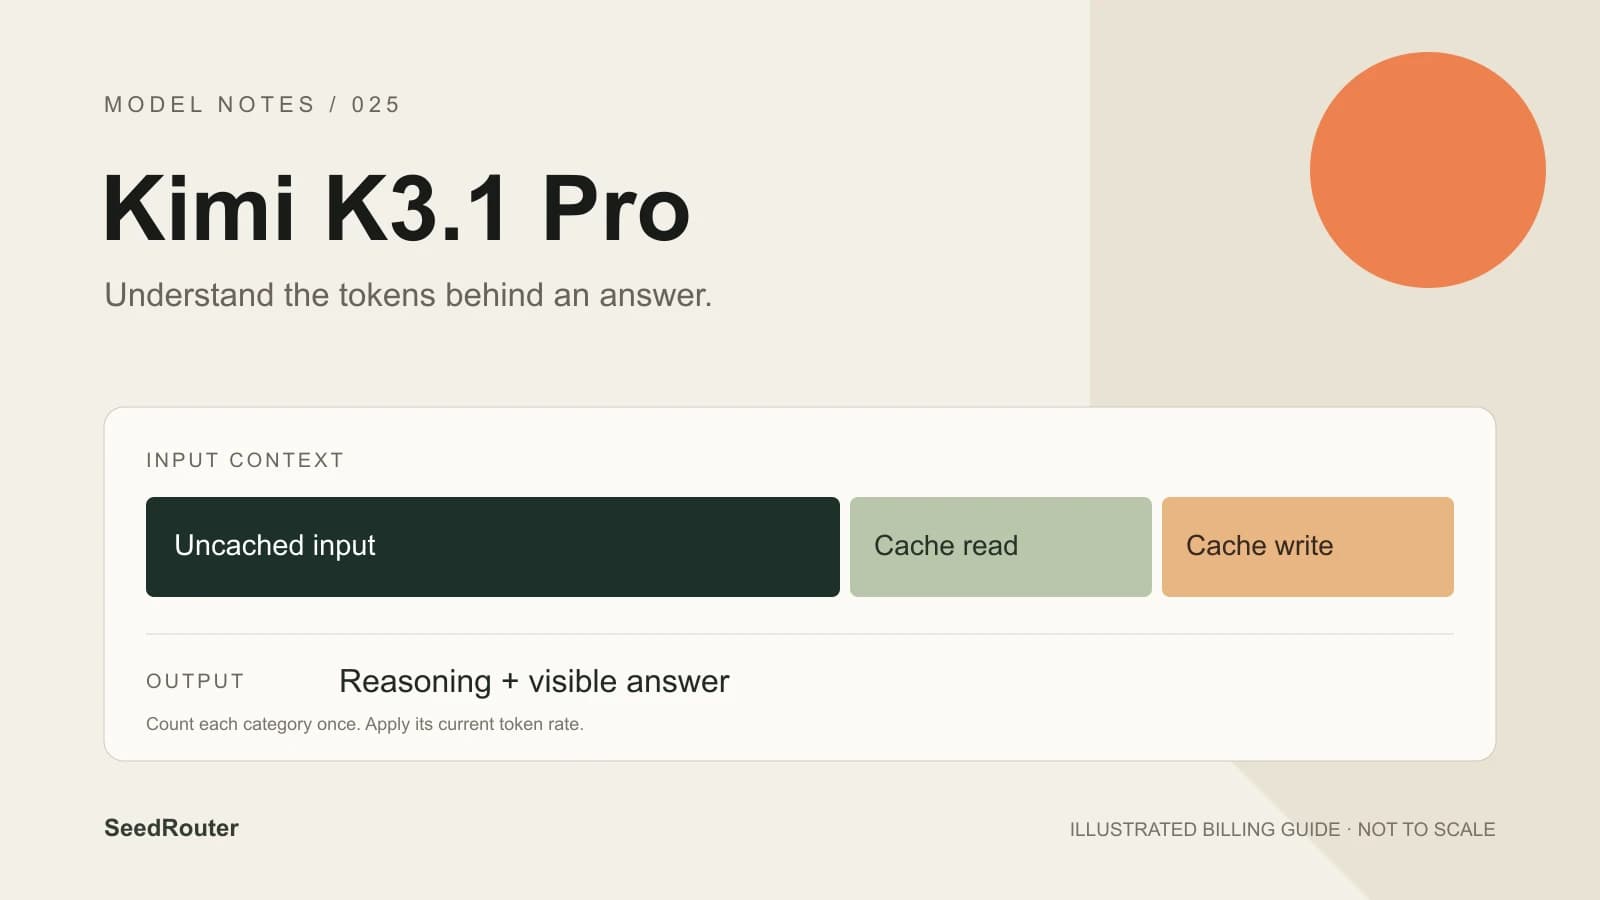
Bei der Schätzung einer Anfrage sind zwei Details entscheidend. Gecachte Token sind Teil des Prompts. Wer sie zur vollständigen Eingabemenge addiert, berechnet denselben Text doppelt. Reasoning-Token gehören zur Ausgabe. Die Länge der sichtbaren Antwort kann den abgerechneten Aufwand daher unterschätzen.
Die GLM-5.3 Modellseite vereint Playground, Modellgrenzen und aktuelle Preise. Dieser Leitfaden erklärt die Rechnung hinter einer Anfrage, ohne einen Cache-Treffer vorauszusetzen oder eine Beispielrechnung als Messwert darzustellen.
Aktuelle GLM-5.3 Preise auf SeedRouter
Die folgende Tabelle liest aktuelle Tarife aus den Abrechnungseinstellungen. Verwenden Sie diese Tarife für Anfragen über diesen Dienst.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
Notieren Sie die Modell-ID neben Ihrer Schätzung: Die Modell-ID für Default ist glm-5.3. GLM-5.3, GLM-5.3-Flash und GLM-5.3-FlashX sind unterschiedliche Modelle. Ein Preis für einen ähnlich klingenden Namen sagt nichts über die Kosten Ihrer Anfrage aus.
Der Kontext von einer Million Token ist eine Kapazitätsgrenze, kein festes Kaufpaket. Eine Anfrage mit wenig Text kauft nicht das gesamte Kontextfenster. Verwenden Sie die tatsächlich zurückgemeldeten Eingabe- und Ausgabemengen dieser Anfrage.[2]
Welche Token gehören in die Rechnung?
Lesen Sie bei einer Chat-Completions-Antwort diese Felder in usage:
| Feld | Bedeutung |
|---|---|
prompt_tokens | Gesamte Eingabe einschließlich gecachter Eingabe |
prompt_tokens_details.cached_tokens | Aus dem Cache bereitgestellter Eingabeanteil |
completion_tokens | Ausgabe einschließlich Reasoning |
total_tokens | Eingabe plus Ausgabe; keine dritte Abrechnungskategorie |
Bei Tarifen pro Million Token lautet die gewöhnliche Rechnung:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
Betrachten Sie eine hypothetische Anfrage mit insgesamt 10.000 Eingabe-Token, 2.000 gecachten Eingabe-Token und 1.000 Ausgabe-Token. Der gewöhnliche Eingabeanteil beträgt 8.000 Token. Mit den oben datierten Z.ai-Listenpreisen ergibt sich (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, also $0,01612. Dies ist ein Rechenbeispiel mit Herstellerpreisen, keine gemessene Anfrage und kein Preisangebot dieses Dienstes.
Meldet eine Antwort Cache-Schreibvorgänge separat, verwenden Sie den geltenden aktuellen Tarif und ziehen Sie auch diesen separat gemeldeten Anteil von der gewöhnlichen Eingabe ab. Leiten Sie keine Schreibmenge aus der Textlänge ab. Die API-Referenz erklärt die Verbrauchsangaben der drei Protokollformate; ihre Feldnamen sind nicht austauschbar.
Was bedeutet gecachte Eingabe?
Der dokumentierte Kontext-Cache von GLM-5.3 arbeitet automatisch. In einer gewöhnlichen Chat-Anfrage müssen Sie keine explizite Cache-Lebensdauer angeben. Ein unverändertes Präfix, etwa Anweisungen gefolgt von Referenzmaterial, ermöglicht Wiederverwendung; Änderungen daran können die Chance auf einen Treffer verändern.[3]
Eignung ist kein Nachweis eines Treffers. Lesen Sie prompt_tokens_details.cached_tokens aus der abgeschlossenen Antwort, statt Einsparungen anhand vertraut wirkender Textmengen zu schätzen. Das offizielle Cache-Beispiel enthält 800 gecachte Token innerhalb von insgesamt 1.200 Prompt-Token; nur die übrigen 400 sind gewöhnliche Eingabe.
Die Preisseite des Herstellers beschreibt Cache-Speicher separat als vorübergehend kostenlos. Das macht weder jede gecachte Anfrage kostenlos noch belegt es eine feste Lebensdauer oder garantiert Cache-Treffer bei wiederholtem Text. Ebenso wenig rechtfertigt es, den Fünf-Minuten- und Ein-Stunden-Schreibplan eines anderen Modells auf GLM-5.3 zu übertragen.[1]
Schätzen Sie konservativ, bis Ihre eigenen Antworten Cache-Verbrauch melden. Für neue Aufgaben bietet eine Rechnung ohne Cache einen brauchbaren Ausgangspunkt. Vergleichen Sie bei repräsentativen Ergebnissen die tatsächliche ungecachte Eingabe, gecachte Eingabe und Ausgabe über vollständige Aufgaben hinweg.
Warum eine kurze Antwort viele Ausgabe-Token nutzen kann
GLM-5.3 nutzt immer Reasoning. Die Aufwandstufen sind low, high und max; dokumentierter Standard ist max. Niedriger Aufwand bedeutet nicht, dass Denken deaktiviert ist. Das Modell akzeptiert thinking.type: "disabled" nicht.[2]
Reasoning und Antworttext teilen sich das Ausgabebudget. Einer Antwort aus einem Satz kann umfangreiches Reasoning vorausgehen, während ein zu kleines Ausgabelimit die Generierung schon vor einer brauchbaren Antwort beendet. Prüfen Sie Abschlussgrund oder Endstatus, bevor Sie entscheiden, ob Ihre Abnahmekriterien erfüllt sind.
Für diese Aufwandstufen ist kein Preismultiplikator dokumentiert. Sie beeinflussen die Bearbeitung einer Aufgabe; die Tokenmengen bestimmen die Rechnung. Vergleichen Sie Einstellungen mit denselben Eingaben und Prüfungen, um die Abwägung für Ihre Anwendung zu verstehen. Erfassen Sie die Gesamtkosten einer abgeschlossenen Aufgabe einschließlich weiterer Anfragen, die Sie bewusst ausführen.
Das Ausgabelimit beträgt 131.072 Token. Das Chat-Anfrageschema nennt kein Standard-Ausgabelimit; Responses dokumentiert einen Standard von 65.536. Keine dieser Zahlen empfiehlt, für eine kleine Aufgabe das Maximum anzufordern. Wählen Sie genügend Budget für Reasoning und gewünschte Antwort und prüfen Sie danach den tatsächlichen Verbrauch.
API-Abrechnung und Coding Plan
Der Coding Plan von Z.ai ist ein separates Abonnementprodukt. Ein Programmierwerkzeug kann API-Anfragen stellen, doch daraus allein ergibt sich nicht, welches Guthaben oder Abonnement dafür zahlt.
Die API-Schlüsselregeln des Herstellers änderten sich am 16. Oktober 2026. Neu ausgestellte Standard-API-Schlüssel und Coding-Plan-Schlüssel haben getrennte Abrechnungstypen. Ein anderer Endpunkt ändert den Abrechnungstyp eines neuen Schlüssels nicht. Für ältere Compatible-Schlüssel gelten andere, endpunktabhängige Regeln. Prüfen Sie bestehende Integrationen daher anhand des aktuellen Leitfadens zur Schlüsselverwaltung.[4]
Anfragen mit einem SeedRouter-Schlüssel nutzen das vorausbezahlte Guthaben und die aktuellen Tarife dieses Dienstes. Ein externes Coding-Plan-Abonnement überträgt sein Kontingent nicht hierher. Halten Sie Schlüsselaussteller, Modell-ID und Tarifquelle gemeinsam in Ihren Integrationsnotizen fest, damit ein Clientwechsel Ihre Kostenannahmen nicht unbemerkt verändert.
Fragen vor Ihrer ersten Anfrage
Ist GLM-5.3 kostenlos?
Anfragen hier nutzen vorausbezahltes Guthaben zu den aktuellen Tarifen oben. Ein Abo ist nicht erforderlich; fehlgeschlagene Anfragen werden nicht berechnet. Auch ein niedriger Tokenpreis ist eine Nutzungsgebühr. Schätzen Sie vor einer Stapelverarbeitung Eingabe und Ausgabe.
Gelten die Preise von GLM-5.3-Flash?
Nein. Dieser Leitfaden behandelt das reine Text-Flaggschiff GLM-5.3. Flash und FlashX haben eigene Modellkennungen, Fähigkeiten und Preise. Gleichen Sie die genaue Modell-ID Ihrer Anfrage mit der verwendeten Tariftabelle ab.
Kostet ein langer Kontext immer mehr?
Die Kapazität selbst wird nicht berechnet. Mehr tatsächliche Eingabe-Token erhöhen gewöhnlich den Eingabeverbrauch; Cache-Treffer können den Tarif für einen Teil davon verändern. Auch eine lange Ausgabe verändert die Gesamtkosten. Vergleichen Sie daher beide Seiten der Anfrage.
Wie schätze ich eine Stapelverarbeitung?
Beginnen Sie mit repräsentativen Aufgaben statt nur einem kurzen Prompt. Erfassen Sie für jede Anfrage Eingabe-, Cache- und Ausgabeverbrauch. Multiplizieren Sie die Mengen mit den geltenden Tarifen und summieren Sie sie über den Stapel. Halten Sie separat fest, ob jedes Ergebnis Ihre Abnahmeprüfungen bestanden hat; günstige unvollständige Antworten sind keine abgeschlossene Arbeit.
Wo kann ich die Parameter prüfen?
Die GLM-5.3 API-Referenz enthält vollständige Feldtabellen für Chat, Responses und Messages. Im Playground können Sie eine Anfrage vor dem Senden prüfen. Beginnen Sie mit einer überprüfbaren Frage und lesen Sie den Verbrauch zusammen mit der Antwort.
Quellen
- Z.ai Preise, geprüft am 29. Oktober 2026.
- GLM-5.3 Modellleitfaden, geprüft am 29. Oktober 2026.
- Kontext-Caching, geprüft am 29. Oktober 2026.
- API-Schlüsselverwaltung, geprüft am 29. Oktober 2026.