תמחור GLM-5.3: עלויות קלט, פלט ומטמון
השווה תעריפי טוקנים של GLM-5.3, קלט מהמטמון והגדרות הסקה. הערך את מחיר הבקשה והפרד בין שימוש ב-API למנוי קוד.
קריאה כ-Markdownתמחור GLM-5.3 מורכב משלוש כמויות עיקריות: קלט רגיל, קלט מהמטמון ופלט. תעריפי המחירון ש-Z.ai מפרסמת הם $1.40, $0.26 ו-$4.40 למיליון טוקנים בהתאמה, נבדקו ב-29 באוקטובר 2026. אלו מחירי היצרן. השתמש בטבלה העדכנית להלן לתעריפים הנוכחיים ב-SeedRouter.[1]
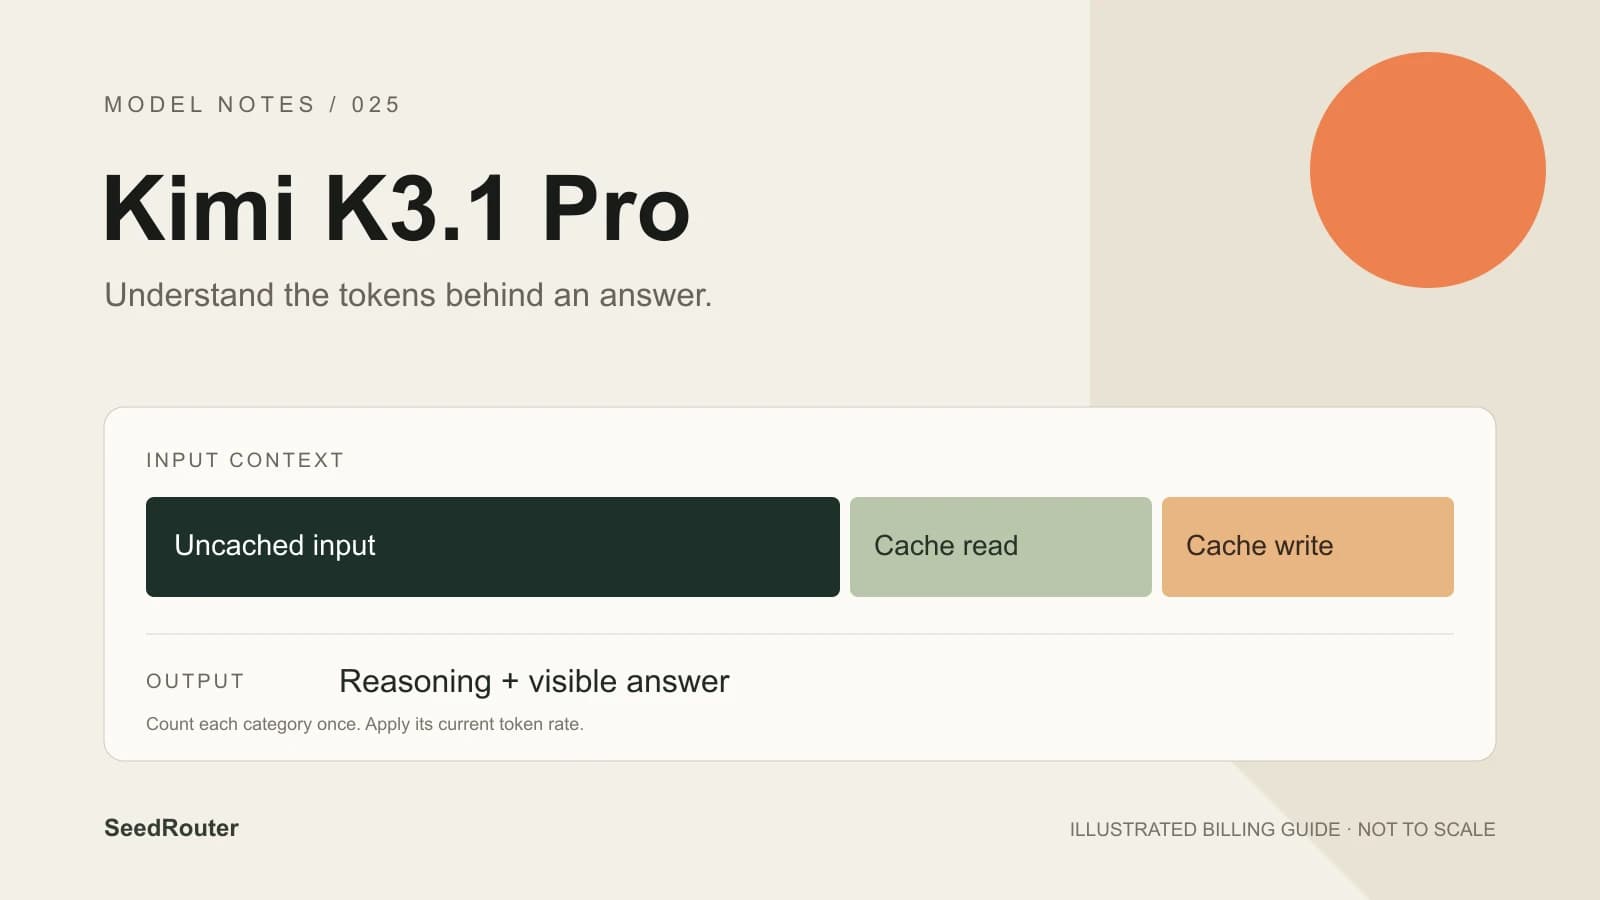
שני פרטים חשובים בהערכת בקשה. טוקנים מהמטמון הם חלק מהפרומפט, ולכן הוספתם לספירת הקלט המלאה מחייבת את אותו טקסט פעמיים. טוקני הסקה הם חלק מהפלט, ולכן אורך התשובה הגלויה עשוי להמעיט בהיקף העבודה שחויבה.
עמוד המודל GLM-5.3 משלב את ה-Playground, מגבלות המודל והמחירים העדכניים. מדריך זה מסביר את חישוב הבקשה בלי להניח פגיעה במטמון או להציג חישוב לדוגמה כתוצאה שנמדדה.
תמחור GLM-5.3 העדכני ב-SeedRouter
הטבלה הבאה קוראת תעריפים עדכניים מהגדרות החיוב. זהו מקור התעריפים לבקשות דרך השירות הזה.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
שמור את מזהה המודל ליד האומדן: מזהה מודל Default הוא glm-5.3. GLM-5.3, GLM-5.3-Flash ו-GLM-5.3-FlashX הם מודלים שונים. מחיר שמוצמד לשם דומה אינו קובע את מחיר הבקשה שלך.
הקשר של מיליון טוקנים הוא מגבלת קיבולת ולא רכישה קבועה. בקשה שמכילה מעט טקסט אינה קונה את חלון ההקשר כולו. השתמש בספירות הקלט והפלט שהוחזרו בפועל לבקשה.[2]
אילו טוקנים נכללים בחישוב?
בתשובת Chat Completions, קרא את השדות הבאים בתוך usage:
| שדה | משמעות |
|---|---|
prompt_tokens | כלל הקלט, כולל קלט מהמטמון |
prompt_tokens_details.cached_tokens | חלק הקלט שסופק מהמטמון |
completion_tokens | פלט, כולל הסקה |
total_tokens | קלט ועוד פלט; לא קטגוריית חיוב שלישית |
כאשר התעריפים נקובים למיליון טוקנים, החישוב הרגיל הוא:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
נבחן בקשה היפותטית עם 10,000 טוקני קלט בסך הכול, 2,000 טוקני קלט מהמטמון ו-1,000 טוקני פלט. חלק הקלט הרגיל הוא 8,000 טוקנים. לפי תעריפי המחירון המתוארכים של Z.ai לעיל, החישוב הוא (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, כלומר $0.01612. זו דוגמה חשבונית בתעריפי היצרן, לא בקשה שנמדדה ולא הצעת מחיר לשירות הזה.
אם תשובה מדווחת בנפרד על כתיבה למטמון, פעל לפי התעריף העדכני המתאים והפחת גם את החלק שדווח בנפרד מהקלט הרגיל. אל תמציא ספירת כתיבה לפי אורך הטקסט. תיעוד ה-API מסביר כיצד שלושת פורמטי הפרוטוקול מבטאים שימוש; שמות השדות שלהם אינם ניתנים להחלפה.
מהו קלט מהמטמון?
מטמון ההקשר המתועד של GLM-5.3 אוטומטי. אין צורך להצהיר על משך מטמון מפורש בבקשת Chat רגילה. שימוש חוזר בקידומת שלא השתנתה, כמו הוראות ולאחריהן חומר עזר, מאפשר שימוש חוזר; שינוי הקידומת עשוי לשנות את הסיכוי לפגיעה.[3]
התאמה לשימוש במטמון אינה ראיה לפגיעה. קרא את prompt_tokens_details.cached_tokens מהתשובה שהושלמה במקום לאמוד חיסכון לפי כמות הטקסט המוכר. דוגמת המטמון הרשמית כוללת 800 טוקנים מהמטמון בתוך 1,200 טוקני פרומפט בסך הכול; רק 400 הנותרים הם קלט רגיל.
עמוד התמחור של היצרן מתאר בנפרד אחסון מטמון כחינמי זמנית. האמירה אינה הופכת כל בקשה עם מטמון להסקה בחינם, אינה קובעת משך שמירה קבוע ואינה מבטיחה שטקסט חוזר יפגע במטמון. היא גם אינה מצדיקה העתקת לוח כתיבה של חמש דקות ושעה ממודל אחר לתמחור GLM-5.3.[1]
שמור על אומדנים שמרניים עד שהתשובות שלך יספקו נתוני שימוש במטמון. אם אתה מתכנן תקציב לעומס חדש, חישוב ללא מטמון מספק נקודת מוצא שימושית. לאחר קבלת תוצאות מייצגות, השווה קלט רגיל, קלט מהמטמון ופלט בפועל לאורך משימות שלמות.
למה תשובה קצרה עשויה להשתמש בטוקני פלט רבים
GLM-5.3 תמיד מסיק. רמות ההסקה הן low, high ו-max, עם max כברירת המחדל המתועדת. רמה נמוכה אינה כיבוי חשיבה. המודל אינו מקבל thinking.type: "disabled".[2]
ההסקה וטקסט התשובה חולקים את תקציב הפלט. לתשובה בת משפט אחד עשויה להקדים הסקה רבה, ותקרת פלט קטנה מדי עלולה לעצור לפני הופעת תשובה שימושית. בדוק את סיבת הסיום או את המצב הסופי לפני שתחליט שהבקשה עמדה בקריטריוני הקבלה.
אין מכפיל מחיר מתועד שמוצמד לשמות הרמות האלו. הן משפיעות על גישת המודל למשימה; ספירות הטוקנים קובעות את החיוב. השווה הגדרות הסקה עם אותם קלטים ובדיקות כדי להבין את הפשרה באפליקציה שלך. תעד את העלות הכוללת של השלמת משימה, כולל בקשות נוספות שתבחר לבצע.
תקרת הפלט היא 131,072 טוקנים. בסכמת הבקשה של Chat אין תקרת פלט מפורסמת כברירת מחדל; ב-Responses מתועדת ברירת מחדל של 65,536. אף מספר אינו המלצה לבקש את המרב למשימה קטנה. בחר תקציב שמשאיר די מקום להסקה ולתשובה הרצויה, ואז בדוק שימוש בפועל.
חיוב API לעומת Coding Plan
Coding Plan של Z.ai הוא מוצר מנוי נפרד. כלי קוד יכול לשלוח בקשות API, אבל הדבר לבדו אינו קובע איזו יתרה או איזה מנוי משלמים עליהן.
כללי מפתחות ה-API של היצרן השתנו ב-16 באוקטובר 2026. מפתחות חדשים של Standard API ושל Coding Plan משתמשים בסוגי חיוב נפרדים. שינוי נקודת הקצה אינו משנה את סוג החיוב של מפתח חדש. למפתחות Compatible ישנים כללים אחרים שתלויים בנקודת הקצה, לכן השתמש במדריך ניהול המפתחות העדכני כשאתה בודק הגדרה קיימת.[4]
בקשות עם מפתח SeedRouter משתמשות ביתרה ששולמה מראש בשירות הזה ובתעריפים העדכניים שלו. מכסת מנוי Coding Plan חיצוני אינה עוברת לכאן. שמור יחד את מנפיק המפתח, מזהה המודל ומקור התעריפים בהערות האינטגרציה, כדי ששינוי לקוח לא ישנה בשקט את הנחות העלות.
שאלות לפני הבקשה הראשונה
האם GLM-5.3 חינמי?
בקשות כאן משתמשות ביתרה ששולמה מראש בתעריפים העדכניים לעיל. אין דרישת מנוי, ובקשות שנכשלו אינן מחויבות. גם תעריף נמוך הוא חיוב על שימוש; הערך קלט ופלט לפני הרצת אצווה.
האם מחירי GLM-5.3-Flash חלים כאן?
לא. המדריך עוסק במודל הדגל הטקסטואלי GLM-5.3. ל-Flash ול-FlashX יש זהויות מודל, יכולות ומחירים משלהם. התאם את מזהה המודל המדויק בבקשה לטבלת התעריפים שבה אתה משתמש.
האם הקשר ארוך תמיד עולה יותר?
הקיבולת עצמה אינה מחויבת. יותר טוקני קלט בפועל בדרך כלל מוסיפים שימוש בקלט, ופגיעות במטמון עשויות לשנות את התעריף לחלק ממנו. גם פלט ארוך משנה את הסכום, לכן השווה את שני צדי הבקשה.
איך להעריך אצווה?
התחל ממשימות מייצגות ולא רק מפרומפט קצר אחד. תעד שימוש בקלט, במטמון ובפלט לכל בקשה. הכפל את הכמויות בתעריפים המתאימים וסכם את האצווה. תעד בנפרד אם כל תוצאה עברה את בדיקות הקבלה; תשובות זולות אך לא מלאות אינן עבודה שהושלמה.
איפה אפשר לבדוק פרמטרים?
השתמש בתיעוד API של GLM-5.3 לטבלאות השדות המלאות של Chat, Responses ו-Messages. ה-Playground מאפשר לבדוק בקשה לפני שליחתה. התחל בשאלה שאפשר לאמת וקרא את נתוני השימוש לצד התשובה.
מקורות
- תמחור Z.ai, נבדק ב-29 באוקטובר 2026.
- מדריך מודל GLM-5.3, נבדק ב-29 באוקטובר 2026.
- מטמון הקשר, נבדק ב-29 באוקטובר 2026.
- ניהול מפתחות API, נבדק ב-29 באוקטובר 2026.