Цены GLM-5.3: стоимость входа, выхода и кэша
Сравните тарифы GLM-5.3, кэшированный вход и настройки рассуждений. Рассчитайте стоимость запроса и отличайте оплату API от подписки для программирования.
Читать в MarkdownЦена GLM-5.3 складывается из трёх основных величин: обычного входа, кэшированного входа и выхода. Опубликованные базовые тарифы Z.ai — соответственно $1,40, $0,26 и $4,40 за миллион токенов, проверено 29 октября 2026 года. Это цены производителя. Текущие тарифы SeedRouter смотрите в таблице ниже.[1]
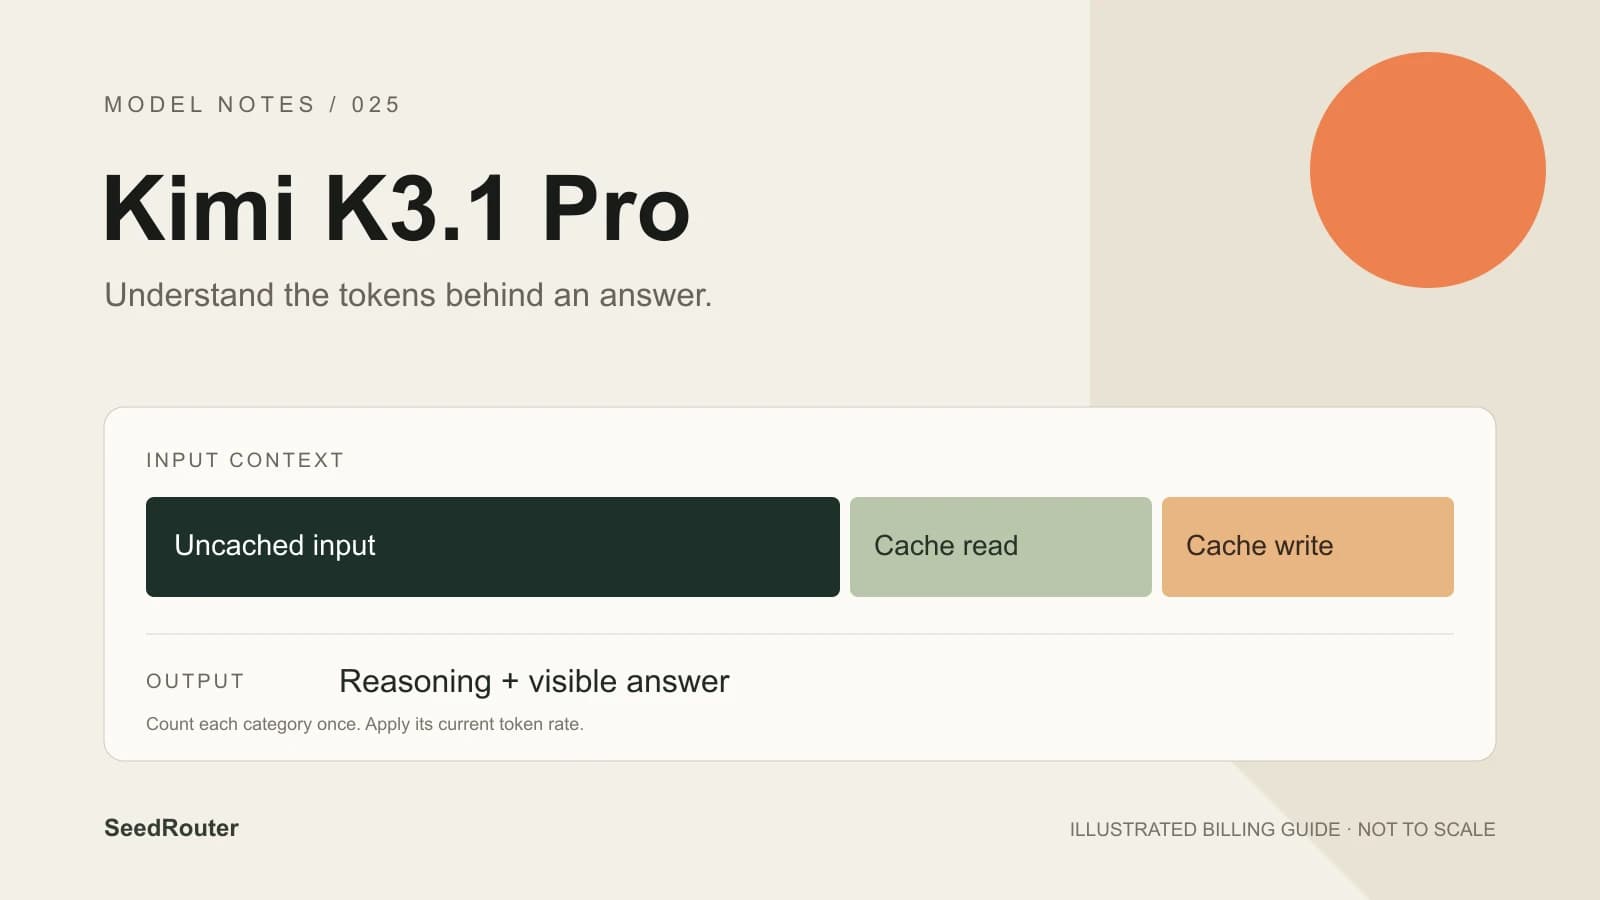
При оценке запроса важны две детали. Кэшированные токены входят в промпт, поэтому прибавление их к полному числу входных токенов учитывает один текст дважды. Токены рассуждений входят в выход, поэтому длина видимого ответа может занижать объём оплаченной работы.
Страница модели GLM-5.3 объединяет Playground, ограничения модели и текущие цены. Это руководство объясняет расчёт запроса, не предполагая попадания в кэш и не выдавая иллюстративный расчёт за результат измерения.
Текущие цены GLM-5.3 на SeedRouter
Таблица получает текущие тарифы из настроек тарификации. Используйте её как источник ставок для запросов через этот сервис.
GLM-5.3
GLM-5.3 current SeedRouter rates, USD per 1M tokens. Read live from the billing settings.
| Model ID | Input | Cached input | Cache write, if reported | Output including reasoning |
|---|---|---|---|---|
glm-5.3:glm | $1.12 | $0.208 | $1.12 | $3.52 |
Cached reads and separately reported writes are part of total input. Subtract them before applying the ordinary input rate. Output already includes reasoning; do not charge it twice. No GLM cache lifetime pricing is assumed. Example: 2,000 uncached input and 1,000 output tokens cost $0.00576. Failed requests are not charged.
Сохраняйте ID модели рядом с оценкой: ID модели Default — glm-5.3. GLM-5.3, GLM-5.3-Flash и GLM-5.3-FlashX — разные модели. Цена модели с похожим названием не определяет стоимость Вашего запроса.
Контекст в миллион токенов — предел ёмкости, а не фиксированная покупка. Запрос с небольшим текстом не покупает всё контекстное окно. Используйте фактические числа входных и выходных токенов, возвращённые для запроса.[2]
Какие токены входят в расчёт?
В ответе Chat Completions читайте следующие поля внутри usage:
| Поле | Значение |
|---|---|
prompt_tokens | Общий вход, включая кэшированный |
prompt_tokens_details.cached_tokens | Часть входа, полученная из кэша |
completion_tokens | Выход, включая рассуждения |
total_tokens | Вход плюс выход; не третья категория оплаты |
При ставках за миллион токенов обычный расчёт выглядит так:
uncached input = total input - cached input

cost = (
  uncached input × input rate
  + cached input × cached-input rate
  + output × output rate
) / 1,000,000
Рассмотрим условный запрос с 10 000 входных токенов всего, 2 000 кэшированных входных и 1 000 выходных. Обычный вход составляет 8 000 токенов. По указанным выше датированным базовым тарифам Z.ai расчёт — (8000 × 1.40 + 2000 × 0.26 + 1000 × 4.40) / 1000000, то есть $0,01612. Это арифметический пример по ставкам производителя, а не измеренный запрос и не ценовое предложение сервиса.
Если ответ отдельно указывает записи в кэш, применяйте соответствующий текущий тариф и также вычитайте эту отдельно указанную часть из обычного входа. Не придумывайте число записанных токенов по длине текста. Справочник API объясняет учёт использования в трёх протоколах; имена их полей не взаимозаменяемы.
Что означает кэшированный вход?
Документированное кэширование контекста GLM-5.3 автоматическое. В обычном запросе Chat не нужно явно объявлять срок хранения кэша. Повторное использование неизменного префикса, например инструкций с последующими справочными материалами, делает повторное использование возможным; изменение префикса может повлиять на вероятность попадания.[3]
Возможность кэширования не доказывает попадания в кэш. Читайте prompt_tokens_details.cached_tokens в завершённом ответе вместо оценки экономии по знакомому тексту. В официальном примере кэширования 800 кэшированных токенов входят в 1 200 общих токенов промпта; только оставшиеся 400 относятся к обычному входу.
Страница цен производителя отдельно описывает хранение кэша как временно бесплатное. Это не делает каждый кэшированный запрос бесплатным, не устанавливает фиксированный срок хранения и не гарантирует попадания повторного текста в кэш. Это также не даёт оснований переносить на GLM-5.3 пятиминутные и часовые тарифы записи другой модели.[1]
Пока Ваши ответы не содержат данных использования кэша, оценивайте расходы консервативно. При планировании новой нагрузки расчёт без кэша даёт полезную отправную точку. Получив репрезентативные результаты, сравнивайте фактический обычный вход, кэшированный вход и выход для полных задач.
Почему короткий ответ может расходовать много выходных токенов
GLM-5.3 всегда использует рассуждения. Доступны уровни low, high и max; документированное значение по умолчанию — max. Низкий уровень не отключает мышление. Модель не принимает thinking.type: "disabled".[2]
Рассуждения и текст ответа делят бюджет вывода. Ответу в одно предложение могут предшествовать значительные рассуждения, а слишком малый лимит вывода может остановить генерацию до появления полезного ответа. Проверьте причину завершения или конечный статус, прежде чем решать, выполнены ли критерии приёмки.
Для этих уровней не документирован ценовой множитель. Они влияют на подход модели к задаче; счёт определяется количеством токенов. Чтобы понять компромисс для приложения, сравнивайте уровни на одинаковых входных данных и проверках. Учитывайте полную стоимость выполнения задачи, включая дополнительные запросы, которые Вы решите сделать.
Предел вывода — 131 072 токена. Для Chat схема запроса не публикует лимит вывода по умолчанию; для Responses указан 65 536. Ни одно число не рекомендует запрашивать максимум для маленькой задачи. Выберите бюджет с запасом для рассуждений и нужного ответа, затем проверьте фактическое использование.
Оплата API и Coding Plan
Coding Plan Z.ai — отдельный продукт по подписке. Инструмент программирования может отправлять API-запросы, но это само по себе не определяет, какой баланс или подписка их оплачивает.
Правила API-ключей производителя изменились 16 октября 2026 года. У новых ключей Standard API и Coding Plan разные типы оплаты. Смена конечной точки не меняет тип оплаты нового ключа. У старых Compatible-ключей другие правила, зависящие от конечной точки; проверяя существующую настройку, используйте актуальное руководство по ключам.[4]
Запросы с ключом SeedRouter расходуют предоплаченный баланс сервиса по текущим тарифам. Лимит внешней подписки Coding Plan сюда не переносится. Храните сведения об издателе ключа, ID модели и источнике ставок вместе в заметках интеграции, чтобы смена клиента не меняла незаметно предположения о расходах.
Вопросы перед первым запросом
GLM-5.3 бесплатна?
Запросы здесь расходуют предоплаченный баланс по текущим тарифам выше. Подписка не требуется, ошибочные запросы не тарифицируются. Даже низкий тариф — плата за использование; перед пакетным запуском оцените и вход, и выход.
Применяются ли цены GLM-5.3-Flash?
Нет. Руководство посвящено текстовому флагману GLM-5.3. У Flash и FlashX свои идентификаторы моделей, возможности и цены. Сопоставляйте точный ID модели в запросе с используемой таблицей тарифов.
Длинный контекст всегда дороже?
Сама ёмкость не оплачивается. Большее фактическое число входных токенов обычно увеличивает использование входа, а попадания в кэш могут менять ставку для его части. Длинный выход тоже влияет на итог, поэтому сравнивайте обе стороны запроса.
Как оценить пакет запросов?
Начните с репрезентативных задач, а не одного короткого промпта. Записывайте вход, кэш и выход каждого запроса. Умножьте эти величины на применимые тарифы и сложите по пакету. Отдельно фиксируйте, прошёл ли каждый результат проверки приёмки: дешёвые незавершённые ответы не означают выполненную работу.
Где посмотреть параметры?
Полные таблицы полей Chat, Responses и Messages — в справочнике API GLM-5.3. Playground позволяет изучить запрос до отправки. Начните с проверяемого вопроса и читайте данные использования вместе с ответом.
Источники
- Цены Z.ai, проверено 29 октября 2026 года.
- Руководство модели GLM-5.3, проверено 29 октября 2026 года.
- Кэширование контекста, проверено 29 октября 2026 года.
- Управление API-ключами, проверено 29 октября 2026 года.