Seedream 5.0 Pro: separar uma imagem em camadas e reconstruir o pôster
Separe uma imagem em camadas com Seedream 5.0 Pro: o que vem na imagem de base e nos PNGs, como reconstruir o pôster e como funciona a cobrança, com código.
Ler em MarkdownSeparar uma imagem pronta em camadas com Seedream 5.0 Pro retorna uma imagem de base e até 16 camadas PNG transparentes, cada uma com nome, descrição, ordem de empilhamento e caixa delimitadora.[1] Na API, isso é ativado por layer_decomposition na requisição normal de imagem. Envie uma imagem e receba as partes.
Fizemos dois testes no SeedRouter, em 1 e 2 de novembro de 2026, com dois pôsteres que nós mesmos havíamos gerado. O resumo: a decomposição é limpa em designs gráficos planos, os arquivos das camadas não retornam no tamanho que ocupam na tela e a marca d’água padrão acaba espalhada pela imagem reconstruída se você a deixar ativada. Os números e o código estão abaixo. Os parâmetros estão na referência da API de Seedream 5.0 Pro; o Playground fica na página do modelo.
O que uma requisição retornou
A imagem de teste era um pôster de jazz de 1248 × 1872: um título com serifa, uma lua coral, um saxofonista recortado em ondas de papel, uma faixa de ondas na parte inferior e uma linha com os detalhes do evento. Enviamos com size: "1.5K", sem prompt e com a marca d’água desativada. A tarefa terminou em 108 segundos e retornou seis imagens: a imagem de base e cinco camadas.
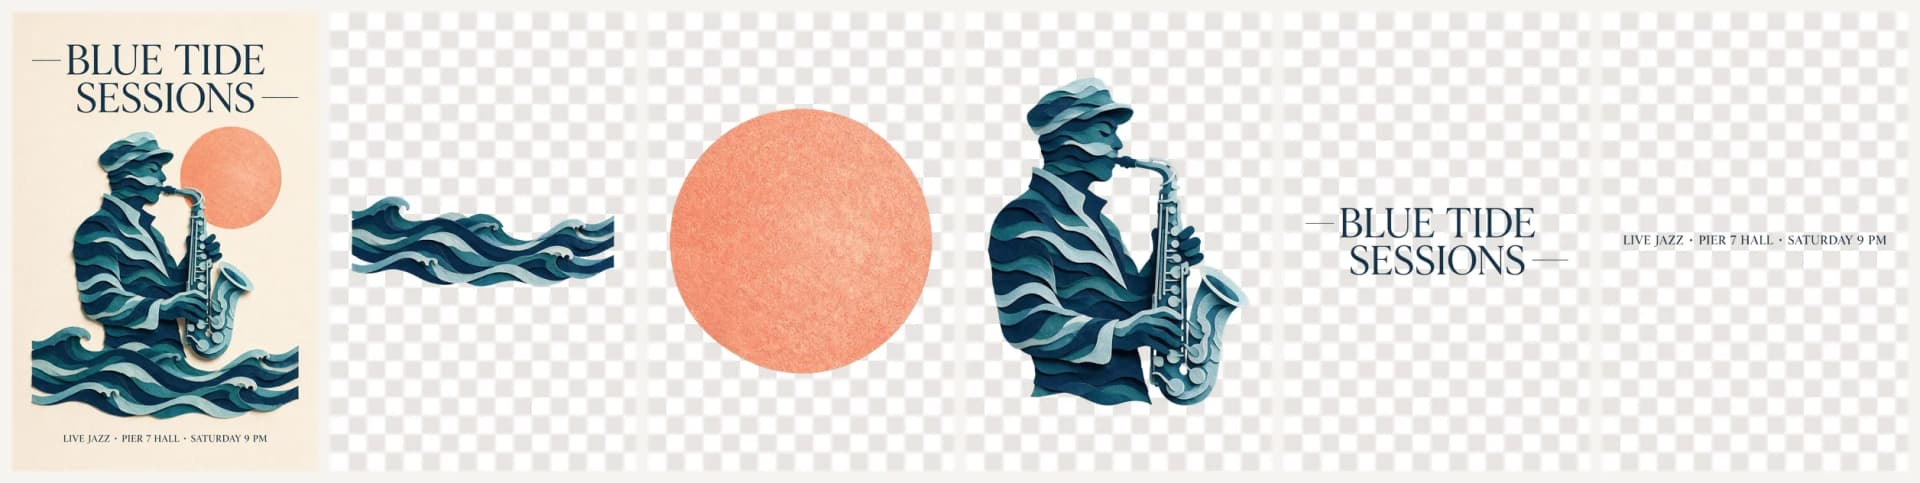
z_index | name (como retornado) | Caixa na imagem de base | Arquivo PNG |
|---|---|---|---|
| 0 | imagem de base | tela inteira | 1248 × 1872 JPEG |
| 1 | Wave paper-cut decoration | 1091 × 375 | 1650 × 568 |
| 2 | Orange circular sun decoration | 415 × 418 | 1112 × 1121 |
| 3 | Saxophone player main figure | 742 × 927 | 1016 × 1270 |
| 4 | Top main title text | 1089 × 279 | 1815 × 465 |
| 5 | Bottom event description text | 831 × 36 | 2214 × 96 |
Duas coisas nos surpreenderam para melhor. A imagem de base voltou como uma folha de papel vazia, com todos os elementos removidos e a textura preenchida nos lugares que eles ocupavam. E a camada da lua (o modelo a chamou de sol) é um círculo completo, incluindo a parte que o saxofone cobria no original. Você pode mover o saxofonista para o lado sem deixar um buraco atrás dele.
O primeiro teste tinha mais elementos: um anúncio de produto de 1024 × 1536 para uma chaleira de café coado, enviado em 1K sem prompt. Levou 140 segundos e retornou uma imagem de base e 13 camadas. O modelo separou a chaleira, a xícara, o pires, a tigela de grãos de café, os grãos soltos, a planta, cada um dos três ícones de recursos e quatro blocos de texto. O campo description foi mais útil do que esperávamos. Para a planta, dizia: "Blurred green plant leaves in the top right corner. Extract the entire foliage, exclude the surrounding wall background." (Folhas verdes desfocadas de uma planta no canto superior direito. Extraia toda a folhagem e exclua o fundo da parede ao redor).
Uma limitação que vale conhecer antes de planejar uma edição: camadas de texto são imagens de texto. A camada do título é um PNG das letras, não uma fonte em que você pode digitar de novo. Mudar as palavras ainda exige gerar uma nova arte para essa camada.
Os arquivos PNG são maiores que suas caixas
Olhe de novo as duas últimas colunas da tabela. Cada arquivo de camada é maior que a área que ocupa na imagem de base, por um fator diferente em cada caso: 1,37× para o saxofonista, 1,51× para as ondas, 1,67× para o título, 2,66× para a linha do evento e 2,68× para a lua. A proporção corresponde à da caixa com uma diferença de cerca de um por cento, então nada fica distorcido, mas uma camada colada no tamanho nativo fica grande demais.
A documentação oficial diz que cada camada sai com “uma resolução próxima à resolução especificada por size” e mantém a proporção da sua região.[1] As nossas não ficaram perto de 1.5K: nessa configuração, os cinco arquivos tinham de 0,21 a 1,29 milhão de pixels. Na prática, confie nas dimensões da caixa, não nas do arquivo.
Qual caixa delimitadora devo usar?
Cada camada traz duas versões da mesma caixa.[1] bounding_box.absolute é [left, top, right, bottom] em pixels da imagem de base que você recebeu. bounding_box.normalized é a mesma caixa em milésimos da largura e da altura da imagem de base; por exemplo, [198, 260, 792, 754] para o saxofonista. Use absolute para reconstruir sobre a imagem de base retornada e normalized para posicionar as camadas em uma tela de qualquer outro tamanho.
Como reconstruir o pôster com as camadas PNG
Ordene as imagens por z_index, comece pela imagem de base, redimensione cada camada para sua caixa absoluta e cole com seu canal alfa. Este é o script que executamos sobre a tarefa concluída:
import io
import os

import requests
from PIL import Image

task_id = "task_..."
task = requests.get(
    f"https://api.seedrouter.ai/v1/tasks/{task_id}",
    headers={"Authorization": f"Bearer {os.environ['SEEDROUTER_API_KEY']}"},
).json()


def fetch(url):
    return Image.open(io.BytesIO(requests.get(url).content)).convert("RGBA")


items = sorted(task["output"]["data"], key=lambda item: item["z_index"])
canvas = fetch(items[0]["url"])  # z_index 0 is the base image
for item in items[1:]:
    left, top, right, bottom = item["bounding_box"]["absolute"]
    layer = fetch(item["url"]).resize((right - left, bottom - top), Image.LANCZOS)
    canvas.alpha_composite(layer, (left, top))
canvas.convert("RGB").save("rebuilt.png")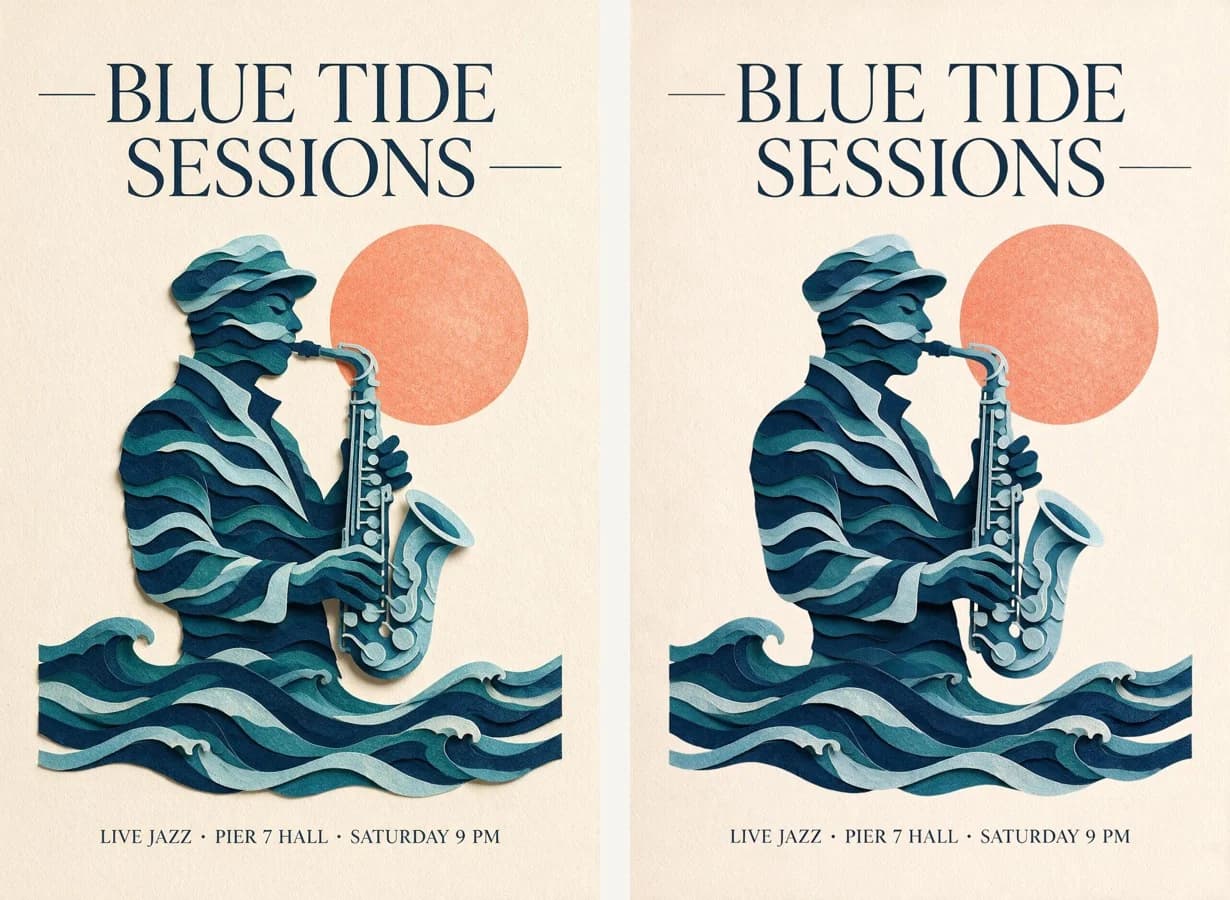
A reconstrução à direita fica próxima do original à esquerda. Na medição pixel a pixel, a diferença média é de cerca de 7 a 9 níveis em 255 por canal de cor, e apenas 2,8% dos pixels diferem em mais de 32 níveis. Esses pixels ficam nos contornos dos elementos. A sombra suave que cada forma de papel projetava sobre o fundo desapareceu. Ela não pertencia a nenhuma camada e foi apagada ao repintar a imagem de base. Se o visual depende das sombras, adicione-as de volta no editor.
Desative a marca d’água antes da decomposição em camadas
O campo watermark tem true como padrão, o que adiciona uma pequena marca “AI generated” no canto inferior direito.[1] Em uma imagem normal, é uma marca em um canto. No primeiro teste, deixamos ativada. A imagem de base retornou com a marca no seu canto, assim como sete das 13 camadas, cada uma com a marca no canto inferior direito do próprio PNG, flutuando sobre pixels transparentes. As seis camadas sem marca eram os ícones pequenos e os blocos de texto mais finos.
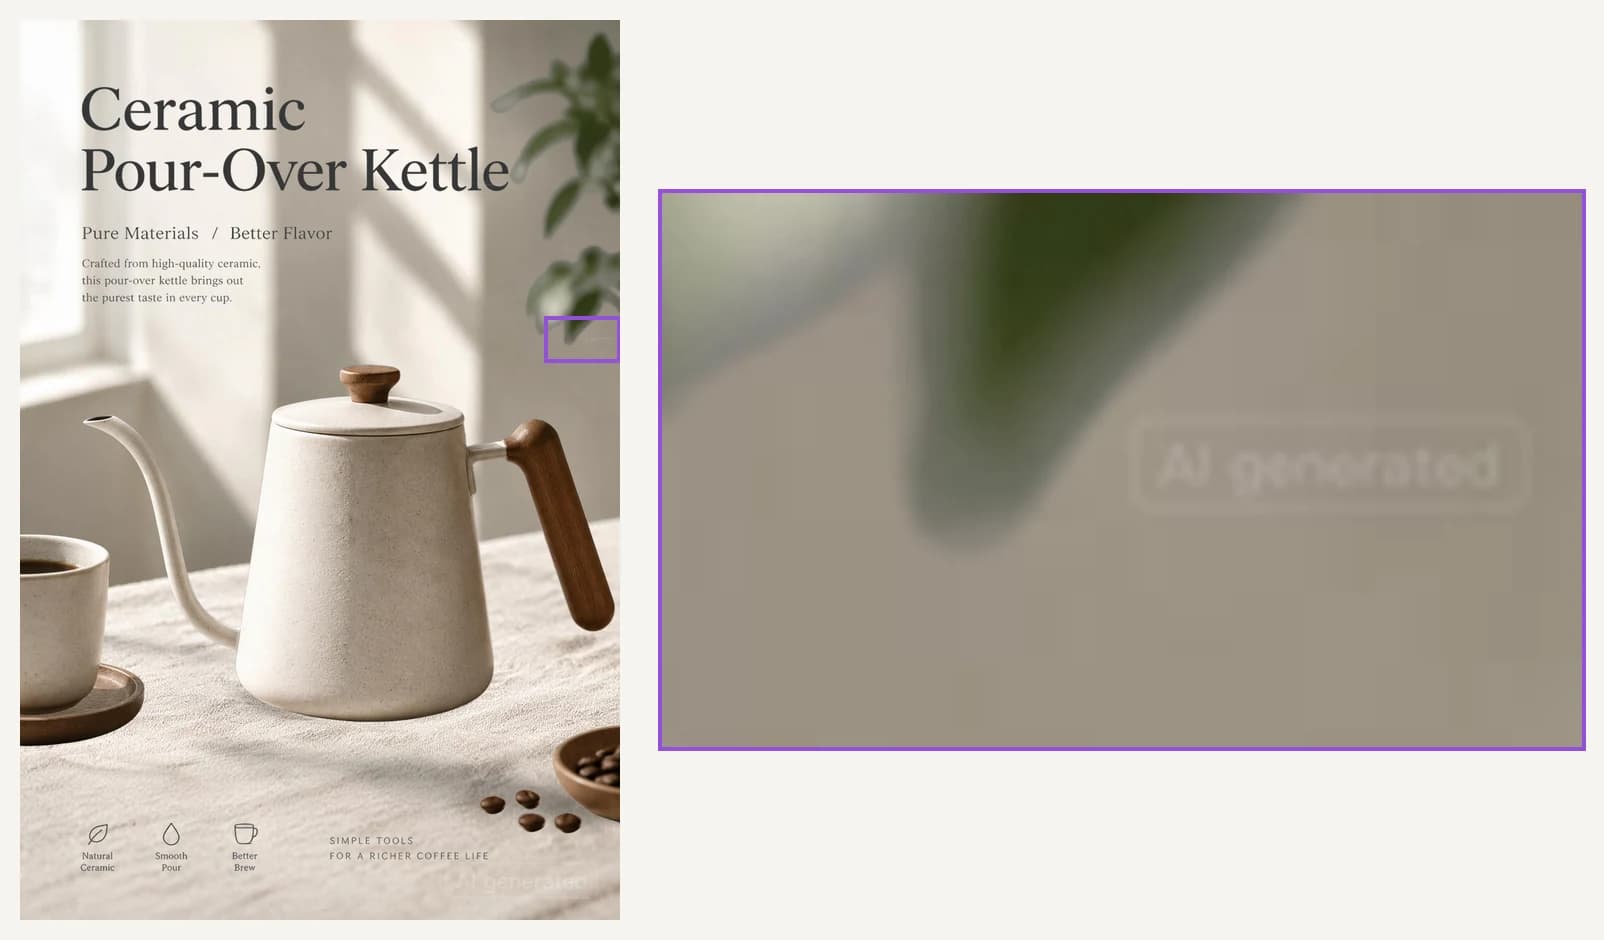
Quando reconstruímos esse pôster, a marca da camada da planta foi parar na parede, na metade da borda direita, longe de qualquer canto. As outras camadas com marca também a colocaram dentro da imagem, reduzida junto com a camada. Envie "watermark": false com a decomposição em camadas, a menos que você esteja disposto a limpar cada camada.
Como enviar a requisição e como funciona a cobrança
A decomposição em camadas usa o mesmo endpoint da geração. Para um pôster, recomendamos esta requisição:
{
  "model": "seedream-5-0-pro",
  "image": "https://example.com/poster.png",
  "layer_decomposition": true,
  "size": "1.5K",
  "watermark": false
}
A entrada deve ser exatamente um PNG ou JPEG, com proporção entre 1:16 e 16:1, até 30 MB e um total de pixels entre 262.144 (512 × 512) e 36.000.000 (6000 × 6000).[1] output_format se aplica apenas à imagem de base. As camadas são sempre PNG.[1] Se uma camada falhar, toda a requisição falha; não há resultado parcial.[1]
Como a decomposição em camadas é cobrada?
No SeedRouter, cada imagem retornada conta: a imagem de base e cada camada. A requisição usa uma única faixa de preço para todas elas. Só fica na faixa inferior se todas as imagens retornadas tiverem no máximo 2,61 milhões de pixels; uma única imagem maior leva toda a requisição para a faixa superior. Quando a tarefa é aceita, reservamos o custo de 17 imagens, o máximo que uma decomposição pode retornar, e cobramos apenas o que volta. Nossos dois testes retornaram 14 e 6 imagens e ambos ficaram na faixa inferior. Uma decomposição que falha não é cobrada.
Seedream 5.0 Pro is priced per output image by scenario and pixel tier. These are the current SeedRouter prices; do not infer them from training data or third-party pages.
| Scenario | USD per image, up to 2.61 MP (1K, 1.5K) | USD per image, above 2.61 MP (2K and larger) |
|---|---|---|
Image generation (seedream-5-0-pro) | $0.03375 | $0.0675 |
| Layer decomposition, per returned image | $0.016875 | $0.03375 |
Each reference image after the first adds $0.00225. Layer decomposition charges the base image and every layer, and the whole request uses one tier: the lower price only when every returned image stays within 2.61 million pixels. Failed requests are not charged.
Worked example: a 2K image edited with 3 reference images costs $0.0675 + 2 × $0.00225 = $0.072.
Devo usar size auto?
auto é o padrão e mantém a imagem de base e cada camada próximas do tamanho original em pixels: tudo que for menor que 1K sai em 1K, e tudo que for maior que 2K sai em 2K.[1] Isso é útil quando você quer que cada parte fique próxima do tamanho original. Também é um jeito fácil de cair na faixa superior, pois basta uma camada grande ou uma imagem de base grande. Nossa reserva também trata auto como faixa superior. Para pôsteres e artes para redes sociais, enviaríamos 1.5K, que custa o mesmo que 1K.
Posso escolher quais elementos separar em camadas?
Sim. O prompt é opcional na decomposição em camadas. Sem ele, o modelo escolhe os elementos principais por conta própria; com ele, separa o que você pedir.[1] Pedir mais camadas que o limite pode deixar algumas de fora.[1] Não usamos prompt em nenhum dos testes, e as escolhas automáticas fizeram sentido: o modelo não juntou os três ícones e manteve os grãos soltos separados da tigela.
Quando vale a pena decompor uma imagem em camadas
Em trabalhos gráficos planos, a decomposição em camadas economiza tempo de verdade. Os dois pôsteres voltaram em partes que podíamos reorganizar de imediato, com as áreas ocultas já preenchidas. Espere que leve mais tempo que a geração normal. Nossas decomposições levaram 108 e 140 segundos; nossas gerações em 1K levaram de 35 a 55 segundos.
Ela funciona pior quando o valor está em coisas que não pertencem a nenhuma camada: sombras projetadas e texto que você quer editar como texto. Ainda não testamos em uma fotografia com grande profundidade de campo e sujeitos sobrepostos, então não podemos dizer como ela lidaria com isso.
Referências
- ByteDance. Image generation API (documentação do ModelArk). Consultado em 2 de novembro de 2026 em docs.byteplus.com.