GPT Image 2.5 Flare vs Sunburst : lequel utiliser ?
Comparez GPT Image 2.5 Flare et Sunburst : vitesse, contrôle des retouches, paramètres et coût, et choisissez le bon ID de modèle pour chaque type d’image.
Lire en MarkdownFlare ou Sunburst ? Utilisez GPT Image 2.5 Flare par défaut et passez à Sunburst lorsqu’une retouche doit être précise. Flare est le choix par défaut d’OpenAI pour la plupart des applications et renvoie les images rapidement. Sunburst est le modèle le plus performant : il garde un contrôle plus strict d’une retouche à l’autre et met plus de temps à générer. Les deux lisent exactement les mêmes champs de requête : passer une tâche de l’un à l’autre se résume à changer un mot dans model.
Cette réponse courte couvre la plupart des décisions. La suite de ce guide explique où la différence se manifeste, ce que coûte chaque option sur SeedRouter et comment tester le choix sur vos propres images au lieu de vous fier à une règle générale.
Quelle différence entre GPT Image 2.5 Flare et Sunburst ?
OpenAI a lancé GPT Image 2.5 le 8 septembre 2026 sous la forme de deux modèles plutôt que d’un seul. Ils partagent le même contrat d’API et diffèrent par la quantité de travail qu’ils consacrent à chaque image.
| Flare | Sunburst | |
|---|---|---|
| Usage prévu | Génération courante, brouillons, gros volumes | Retouches précises et visuels finaux |
| Vitesse | Rapide | Plus lent, temps de génération plus longs |
| Contrôle des retouches | Bon | Contrôle plus strict d’une retouche à l’autre |
| Champs de requête | Les mêmes 12 champs | Les mêmes 12 champs |
| Niveaux de qualité | De auto à max | De auto à max |
Le tableau est volontairement court. Aucun des deux modèles n’ajoute un paramètre qui manquerait à l’autre, et aucun n’est limité à un format plus petit. La différence pratique est le compromis entre le temps d’attente et la fidélité avec laquelle le résultat conserve ce que vous lui avez demandé de conserver.
Quand choisir GPT Image 2.5 Flare ?
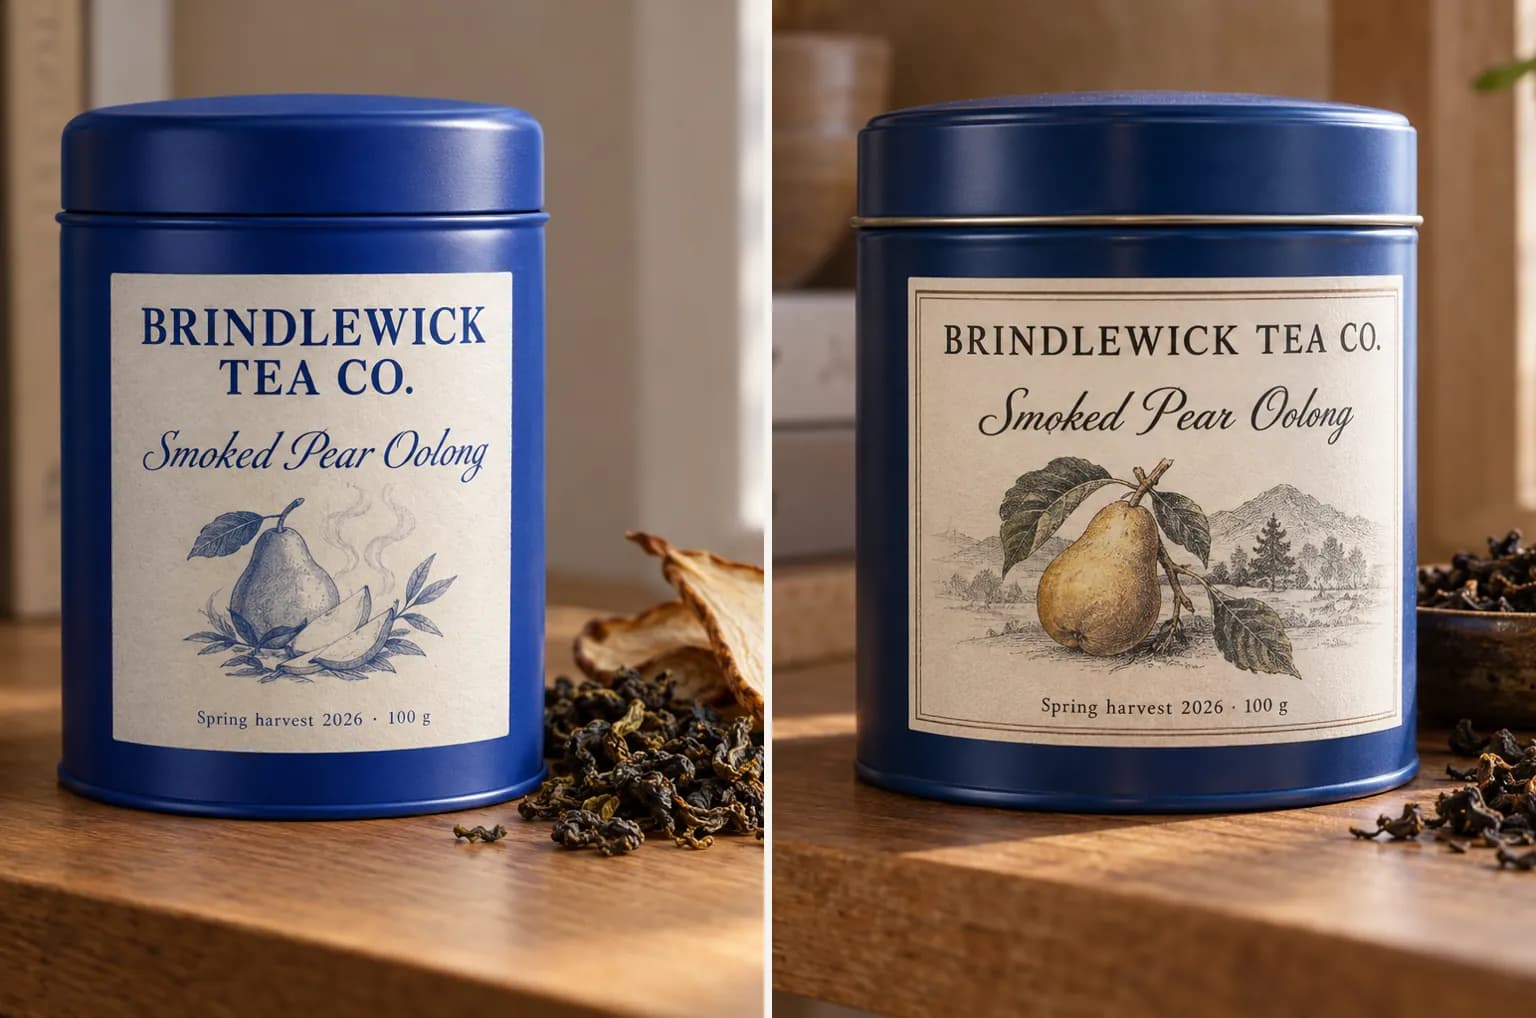
Choisissez Flare lorsque vous allez regarder beaucoup d’images pour n’en garder que quelques-unes. Déclinaisons pour les réseaux sociaux, exploration de concepts, miniatures et premières versions d’une mise en page entrent dans ce cas. Si une requête demande dix images et que vous comptez en choisir une, le modèle le plus rapide raccourcit toute la boucle.
Flare est aussi le point de départ logique pour un nouveau prompt. Écrivez le prompt, lancez-le sur Flare en low ou medium, et corrigez les problèmes de composition tant que chaque essai est rapide. Passer à Sunburst avant que le prompt soit stabilisé ne fait surtout qu’allonger chaque essai raté.
Quand Sunburst vaut-il l’attente ?
Sunburst justifie son temps sur les retouches. Lorsque vous envoyez des images de référence avec images, ou un mask qui délimite une zone à modifier, la tâche revient généralement à « change ceci, garde tout le reste ». C’est précisément le cas où un contrôle plus strict d’une retouche à l’autre compte : un changement de couleur de produit qui ne doit pas déplacer l’étiquette, ou un remplacement d’arrière-plan qui doit laisser le sujet intact.
C’est aussi le meilleur candidat pour un visuel final une fois le prompt arrêté. Lancez le prompt stabilisé sur Sunburst à un niveau de qualité plus élevé et comparez-le côte à côte avec la version Flare. Si vous ne voyez aucune différence dans les parties de l’image que votre public regardera, gardez Flare.
Flare et Sunburst ont-ils un prix différent ?
Vérifiez le tarif actuel de chaque ID de modèle et de chaque qualité. Flare et Sunburst n’ont pas de prix commun garanti ; la facturation dépend aussi du choix entre Standard et Official.
- ID Standard (
gpt-image-2.5-flare,gpt-image-2.5-sunburst) : chaque image livrée est facturée au tarif actuel du modèle et de la qualité choisis. - Les ID Official (
gpt-image-2.5-flare-official,gpt-image-2.5-sunburst-official) facturent les tokens déclarés à chaque rendu : la qualité et la taille modifient donc le coût.
Voici les tarifs actuels, lus en direct dans la même grille que celle qui facture votre compte :
GPT Image 2.5 prices are listed separately for each model ID. Per-image prices follow the selected quality; token-billed prices follow reported usage.
| Channel | Model IDs | Billed by | Current rate (USD) |
|---|---|---|---|
| Standard | gpt-image-2.5-flare | Per delivered image at the selected model and quality rate | Per delivered image: xhigh $0.0225; max $0.0225; other quality values $0.021 |
| Standard | gpt-image-2.5-sunburst | Per delivered image at the selected model and quality rate | Per delivered image: xhigh $0.0225; max $0.0225; other quality values $0.021 |
| Official | gpt-image-2.5-flare-official | Tokens each render reports (text input + image output) | $3.75 per 1M input tokens; $22.5 per 1M output tokens |
| Official | gpt-image-2.5-sunburst-official | Tokens each render reports (text input + image output) | $3.75 per 1M input tokens; $22.5 per 1M output tokens |
Token rates are the published first-tier rates; usage in a different tier may be charged differently.
Cost of one 1024x1024 image by quality
Token counts are measured samples on the Official channel, with 18 input tokens for the prompt. Actual usage varies with the prompt, dimensions, references, and image count, so token-billed figures are estimates, not fixed prices. Per-image rates below follow each model's current quality pricing.
| Quality | Sample output tokens | Standard · GPT Image 2.5 Flare USD | Standard · GPT Image 2.5 Sunburst USD | Official · GPT Image 2.5 Flare USD | Official · GPT Image 2.5 Sunburst USD |
|---|---|---|---|---|---|
| low | 196 | $0.021 | $0.021 | $0.0044775 | $0.0044775 |
| medium | 439 | $0.021 | $0.021 | $0.009945 | $0.009945 |
| high | 1756 | $0.021 | $0.021 | $0.0395775 | $0.0395775 |
| xhigh | 3122 | $0.0225 | $0.0225 | $0.0703125 | $0.0703125 |
| max | 7024 | $0.0225 | $0.0225 | $0.1581075 | $0.1581075 |
| auto | 229 | $0.021 | $0.021 | $0.00522 | $0.00522 |
Formula (Official): (input tokens × 3.75 + output tokens × 22.5) / 1,000,000 USD. A request for n images is billed for the images delivered. Final charges are available in account usage history. Failed requests are not charged.
Les tarifs Standard peuvent varier selon le modèle et la qualité ; consultez le tableau pour le niveau prévu. Les frais Official dépendent de l’usage déclaré, et les niveaux de qualité supérieurs consomment généralement davantage de tokens de sortie.
Qu’est-ce qui change par rapport à GPT Image 2 ?
Trois points comptent pour une intégration. D’abord, GPT Image 2.5 ajoute deux niveaux de qualité, xhigh et max, au-dessus de high, là où GPT Image 2 s’arrête. Ensuite, il se présente sous la forme de deux modèles au lieu d’un seul, ce qui est justement le choix dont traite ce guide. Enfin, la forme de la requête n’a pas changé : même point de terminaison, mêmes noms de champs, entrées par URL pour les références et les masques, et même flux de tâches asynchrone.
Ce dernier point rend la mise à niveau peu coûteuse à essayer. Gardez votre requête GPT Image 2, remplacez model par gpt-image-2.5-flare et comparez le résultat. La référence GPT Image 2.5 liste chaque champ et chaque contrainte si vous voulez utiliser les nouveaux niveaux de qualité.
Comment tester le choix sur vos propres images ?
Une règle générale est un point de départ, pas un verdict. Lancez une petite comparaison avec le prompt que vous utilisez réellement en production :
- Choisissez trois briefs : une génération simple, une retouche avec référence et l’image la plus difficile que vous prévoyez de produire.
- Envoyez chacun à Flare et à Sunburst avec la même
size, la mêmequalityet le même prompt. - Ne regardez que ce qui compte pour votre usage, comme une étiquette, un visage ou le bord d’un produit.
- Notez le temps d’attente de chaque tâche à côté de l’image.
Si Sunburst ne l’emporte que sur le brief de retouche, envoyez les retouches à Sunburst et tout le reste à Flare. Comme les champs sont identiques, cet aiguillage tient en une seule condition dans votre code.
Questions fréquentes
Puis-je passer de Flare à Sunburst sans modifier ma requête ?
Oui. Changez le champ model et rien d’autre. Les deux modèles acceptent le même prompt, la même taille, la même qualité, le même arrière-plan, le même format de sortie, le même nombre d’images, les mêmes références et le même masque.
Quel modèle utiliser pour un fond transparent ?
L’un ou l’autre. Réglez background sur transparent et output_format sur png. La transparence est un réglage de la requête, pas une fonctionnalité propre à un niveau.
Sunburst donne-t-il toujours une meilleure qualité ?
C’est le modèle le plus performant, mais « meilleur » dépend de la tâche. Sur des brouillons rapides, vous ne verrez peut-être aucune différence qui justifie le temps supplémentaire. Comparez les deux sur vos propres briefs avant de décider.
Commencez par Flare, prouvez l’intérêt de Sunburst
Partez de Flare par défaut, stabilisez le prompt avec lui, et ne passez une tâche à Sunburst que lorsqu’une comparaison côte à côte montre la différence que vos utilisateurs remarqueront. Essayez les deux dans le Playground GPT Image 2.5, et consultez l’annonce de GPT Image 2.5 par OpenAI pour la description des deux modèles par l’éditeur lui-même.